Jak zbudować duży model językowy od zera? Toktumi 3.0 – Część 3 (i ostatnia)
Toktumi 3.0 – polski model LLM oparty na GPT-2. Fine-tuning, 100% danych syntetycznych i jeszcze lepsze wyniki.
ROZDZIAŁ III. Toktumi 3.0. Trzeci trening.
1. Cel ponownego treningu
Toktumi 2.0 był znacznym postępem w stosunku do Toktumi 1.0, ale nadal miał problemy z poprawnością odpowiedzi, rozumieniem niektórych pojęć i zapętlaniem tekstu. (Szczegóły – zobacz Część 2).
Wcześniejsze eksperymenty pokazały, że uczenie na parach pytanie–odpowiedź (QA) oraz polecenie–odpowiedź (IA) przynosi dobre rezultaty. Postanowiłem więc rozwinąć to podejście, wykorzystując wcześniej zgromadzone teksty oraz API Google Gemini (Gemini 3.1 Flash-Lite) do syntetycznego generowania danych treningowych.
Chciałem sprawdzić, czy dalsze uczenie modelu wyłącznie na krótkich, uporządkowanych pytaniach, instrukcjach i dialogach pozwoli uzyskać lepsze rezultaty niż trening oparty głównie na surowych tekstach.
Podobnie jak poprzednie etapy, projekt ma charakter niekomercyjny i edukacyjno-badawczy.
2. Nowa koncepcja danych treningowych
W poprzednich wersjach Toktumi znaczną część korpusu stanowiły surowe teksty pozyskane z internetu: artykuły, książki, komentarze internetowe i inne materiały. W Toktumi 3.0 postanowiłem całkowicie zmienić to podejście.
Zamiast uczyć model bezpośrednio na surowych tekstach, cały korpus treningowy został przygotowany w formie krótkich, uporządkowanych rekordów, generowanych na podstawie materiałów źródłowych.
Przyjęto trzy podstawowe rodzaje rekordów:
- Pytanie → odpowiedź (QA) — rozwijanie wiedzy i rozumienia pojęć.
- Polecenie → odpowiedź (IA) — uczenie wykonywania instrukcji.
- Wypowiedź → reakcja (dialog) — rozwijanie umiejętności prowadzenia rozmowy.
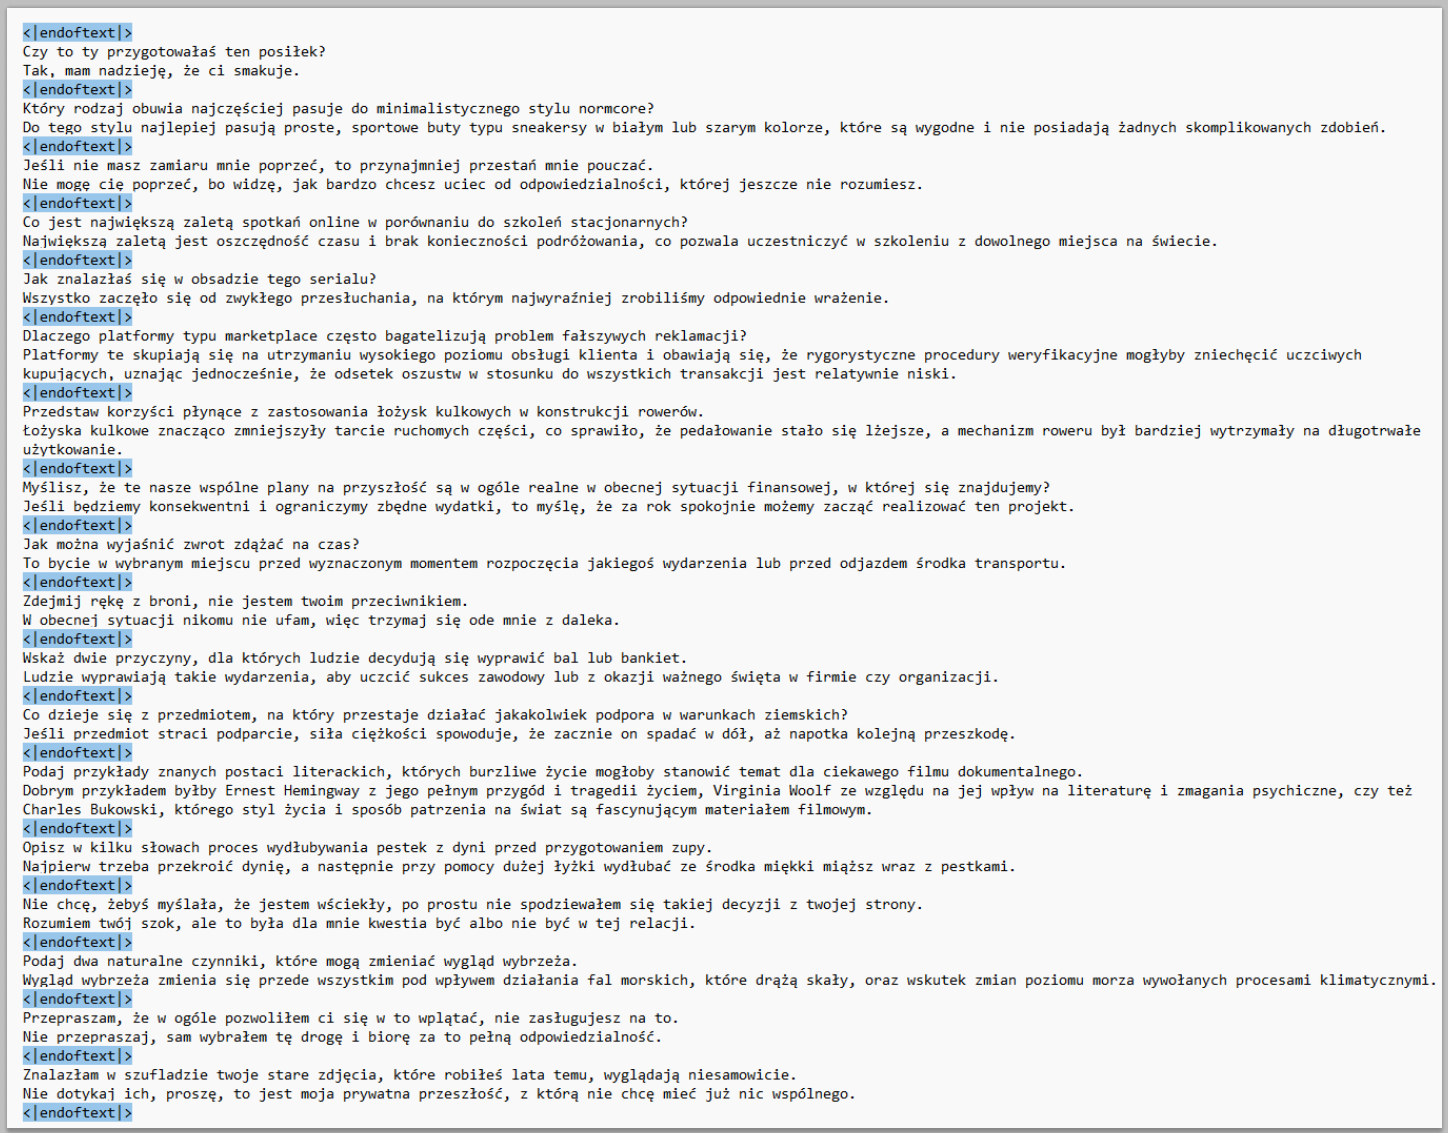
Przykładowe kategorie rekordów:
Pytanie i odpowiedź:
Jaka jest stolica Francji?
Stolicą Francji jest Paryż.
<|endoftext|>
Polecenie i odpowiedź:
Wymień trzy planety Układu Słonecznego.
Merkury, Wenus i Ziemia.
<|endoftext|>
Dialog:
Chyba zapomniałem zabrać parasola.
Może sprawdź prognozę pogody, zanim wyjdziesz.
<|endoftext|>
Ważnym założeniem była samodzielność każdego rekordu. Pytanie lub polecenie musiało być zrozumiałe bez znajomości artykułu źródłowego czy pozostałych rekordów.
3. Wybór i pozyskanie materiałów źródłowych
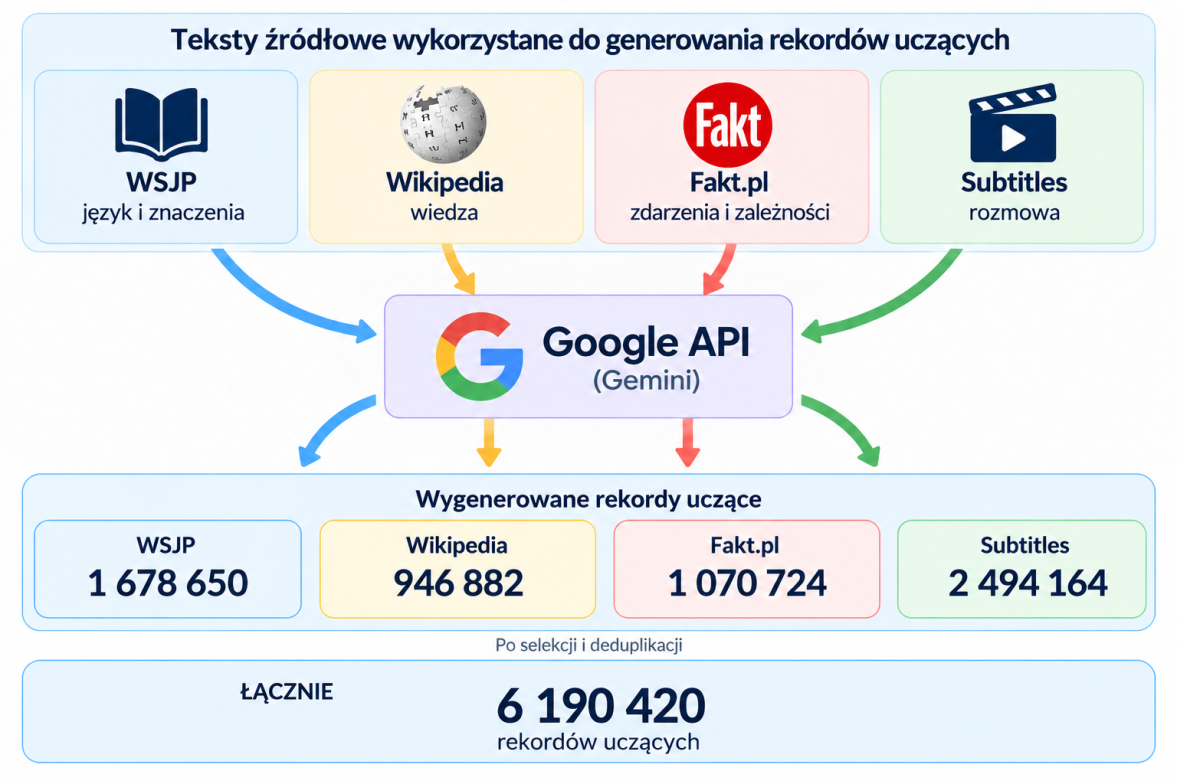
Do przygotowania korpusu Toktumi 3.0 postanowiłem wybrać cztery główne źródła już zgromadzonych tekstów (zob. części o Toktumi 1.0 i Toktumi 2.0): Wielki słownik języka polskiego (WSJP), Wikipedię, Fakt oraz napisy filmowe i serialowe.
Każde źródło miało rozwijać inne umiejętności modelu:
- WSJP — język i znaczenia. Źródło danych zawierające definicje słów, związki frazeologiczne, typowe połączenia wyrazowe i przykłady użycia. Materiały miały poprawić rozumienie polskiego słownictwa i definiowanie pojęć.
- Wikipedia — wiedza. Artykuły encyklopedyczne dostarczające informacji o świecie i mające rozwijać umiejętność odpowiadania na pytania faktograficzne.
- Fakt.pl – wydarzenia. Artykuły prasowe dostarczające wiedzy o konkretnych wydarzeniach, ludziach i relacjach przyczynowo-skutkowych.
- Subtitles — rozmowa. Dialogi przygotowane na podstawie napisów do filmów miały nauczyć model prowadzenia naturalnej konwersacji oraz reagowania na emocje rozmówcy.
Wygenerowane próbki wg źródeł:
4. Generowanie danych treningowych
Do automatycznego tworzenia rekordów treningowych wykorzystałem przede wszystkim API Google Gemini. Od prac nad Toktumi 2.0 (2025) minął około rok. W tym czasie pojawiły się nowe, bardziej zaawansowane modele. Wcześniejszy Gemini 2.5 Flash (obecnie wycofywany) zastąpiłem modelem Gemini 3.1 Flash-Lite.
Dodatkowo korzystałem z uruchamianego lokalnie modelu Gemma 4 31B, który zastąpił wcześniejszy Mistral NeMo 12B. W moich testach Gemma lepiej radziła sobie z językiem polskim niż równie popularny obecnie (2026) Qwen3.6-35B-A3B.
Mechanizm działania: skrypt w Pythonie przesyła przez API do modelu Gemini 3.1 Flash-Lite kolejne teksty źródłowe wraz z odpowiednim promptem, określającym zasady generowania. Na podstawie każdego tekstu model tworzy 20 lub 30 rekordów treningowych w formie par Pytanie–Odpowiedź oraz Instrukcja–Odpowiedź. Gotowe rekordy są automatycznie zapisywane do plików txt.
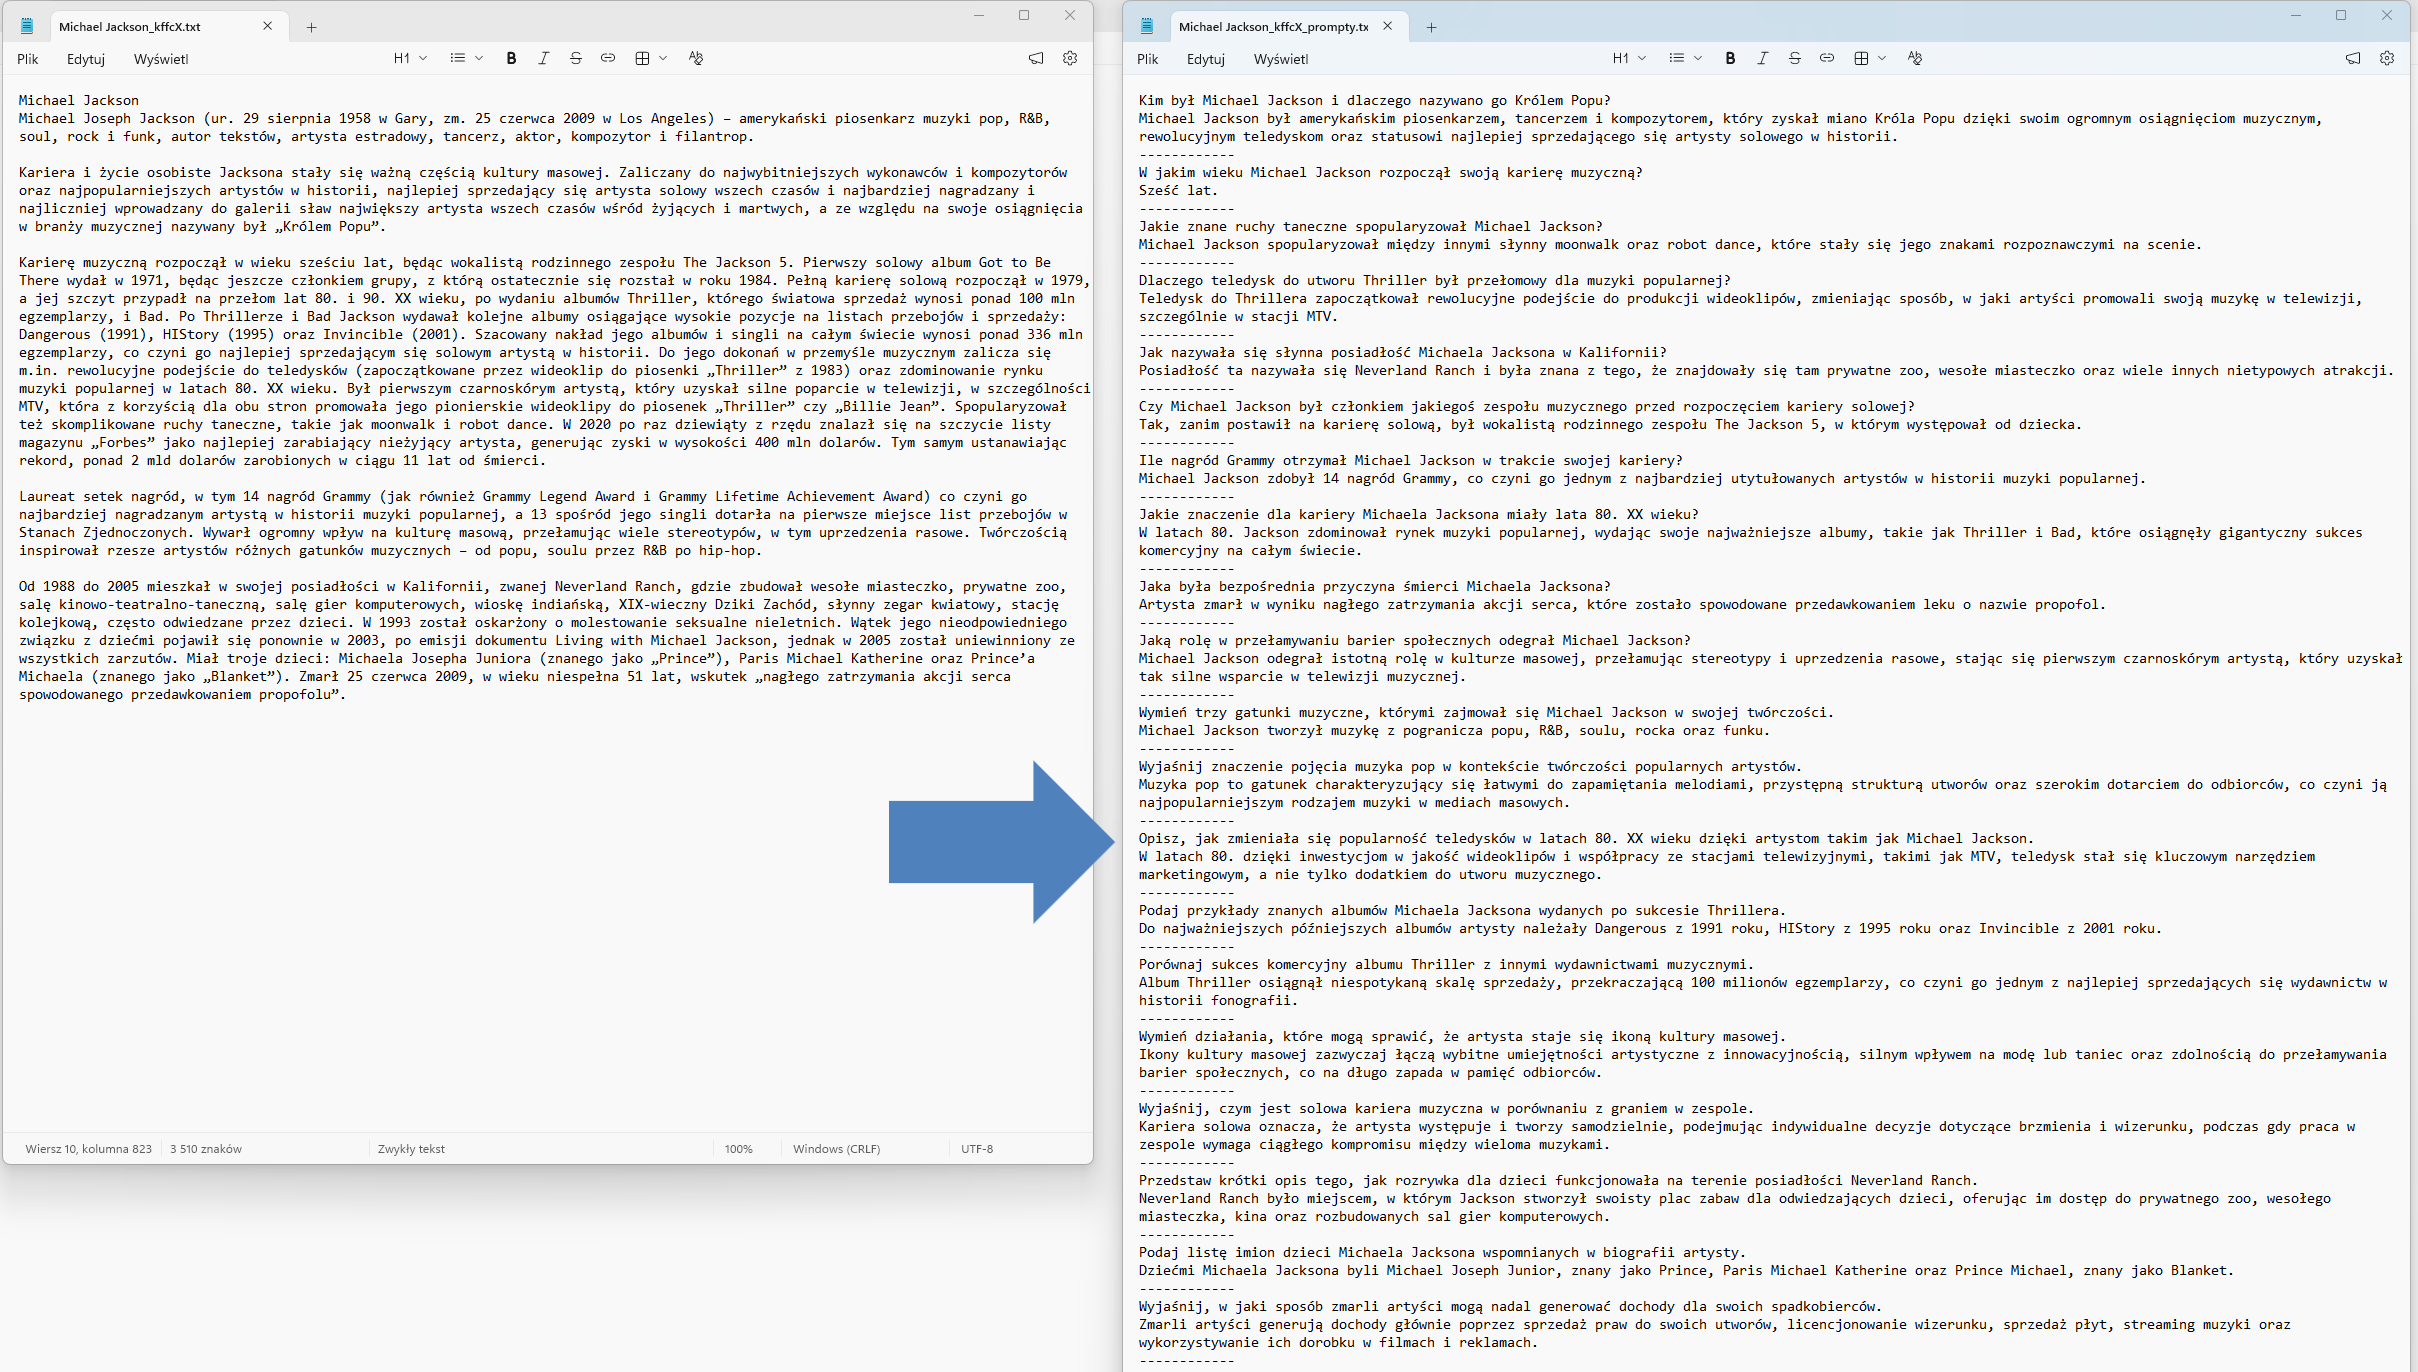
Przy Toktumi 3 po raz pierwszy wykorzystałem napisy filmowe (subtitles) jako źródło danych treningowych. Duży zbiór napisów zgromadziłem już wcześniej ze źródeł internetowych, jednak początkowe próby pokazały, że surowe teksty dialogów nie nadają się do uczenia — model generuje chaotyczne ciągi wypowiedzi, nie rozpoznając rozmówców ani momentu, w którym należy zakończyć wypowiedź.
Rozwiązaniem okazało się dopiero przetworzenie napisów w krótkie, samodzielne pary dialogowe, w których jedna wypowiedź stanowi logiczną reakcję na drugą. W tej formie napisy mogły posłużyć do uczenia prowadzenia prostej rozmowy.
Przetwarzanie fragmentu napisów w zestaw par treningowych:
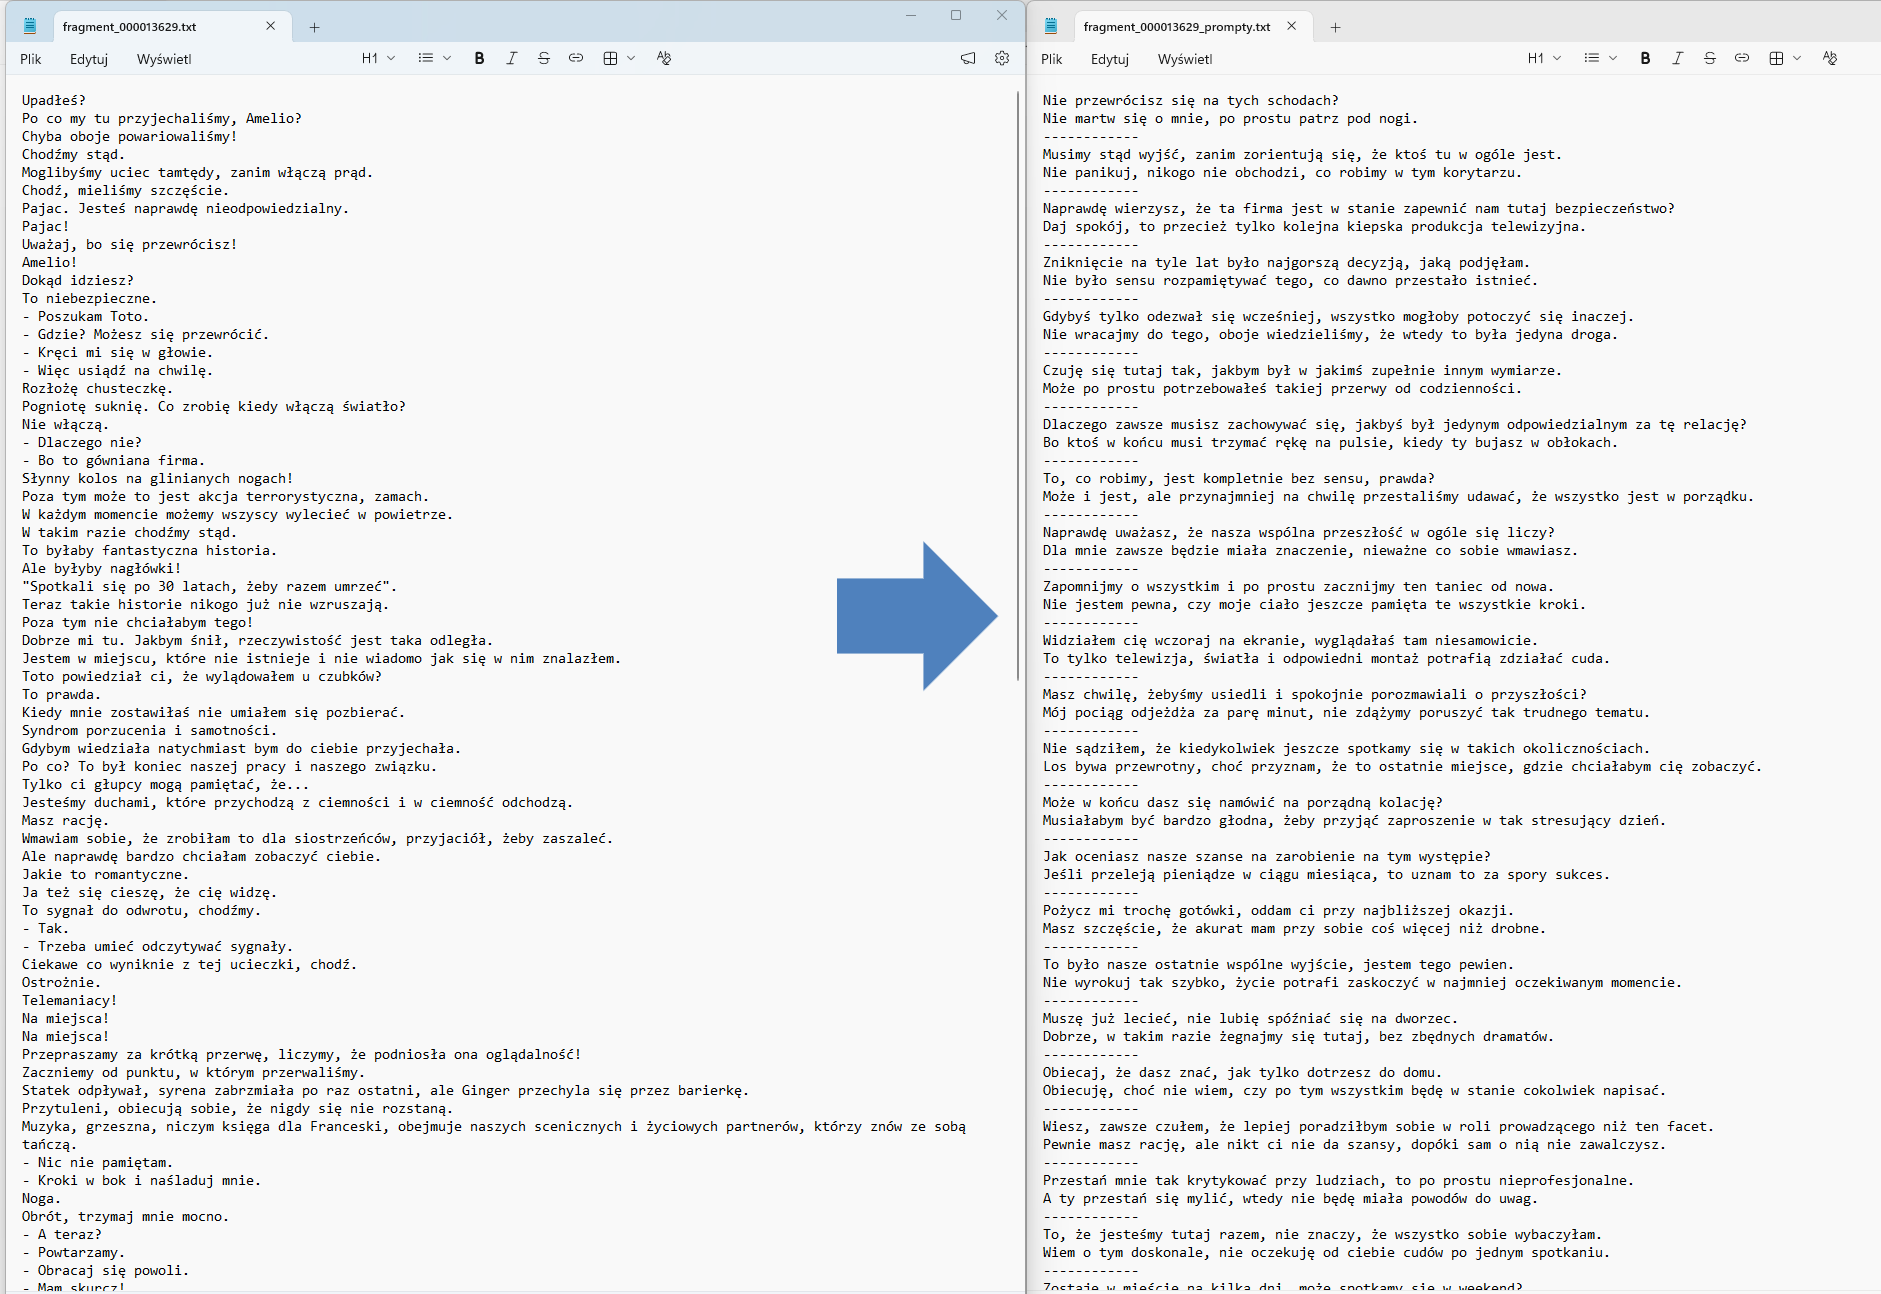
Kod i prompt do generowania danych działały na podobnej zasadzie jak w Toktumi 2.0 (zobacz Część 2).
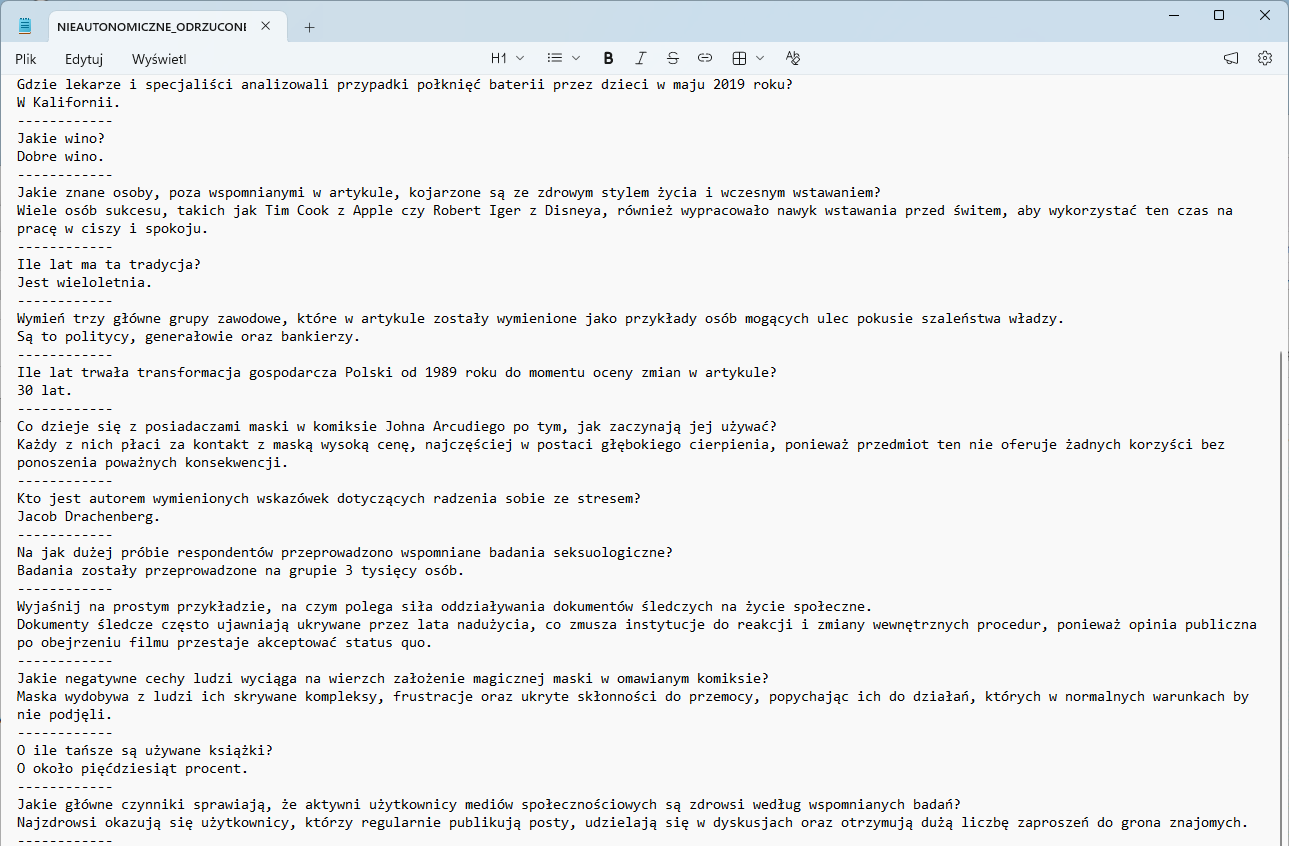
Rekordy wygenerowane ze wszystkich czterech źródeł wymagały sprawdzenia pod kątem autonomiczności. Każde pytanie lub polecenie musiało być zrozumiałe samodzielnie, bez znajomości artykułu źródłowego czy wcześniejszego kontekstu.
Model automatycznie oceniał rekordy i oznaczał je jako 1 – zostaw lub 0 – odrzuć. W ten sposób eliminowałem pytania odwołujące się do nieznanych osób, wydarzeń czy wcześniejszych wypowiedzi.
Poniżej przykłady odrzuconych, nieautonomicznych rekordów wygenerowanych na podstawie artykułów newsowych.
PRĘDKOŚĆ PRZETWARZANIA DANYCH
Gemini przez API przetwarzał około 7–8 tekstów źródłowych na minutę (około 10 tys. na dobę), a lokalna Gemma 4 w wersji GGUF około 1–2 tekstów na minutę (około 2 tys. na dobę). Są to wartości szacunkowe.
Wygenerowanie i oczyszczenie wszystkich 6 190 420 par treningowych zajęło około 2,5 miesiąca.
5. Przygotowanie finalnego korpusu Toktumi 3.0
Podobnie jak w poprzednich wersjach Toktumi, połączyłem przygotowane dane w jeden duży korpus treningowy. Przedtem wymieszałem wszystkie 6 190 420 rekordów, aby podczas uczenia przeplatały się pytania, instrukcje i dialogi. Następnie podzieliłem zbiór na 99% danych treningowych (TRAIN) i 1% walidacyjnych (VALID), oddzielając rekordy tokenem <|endoftext|> - rozpoznawanym przez model jako znacznik końca tekstu.
Tu drobna uwaga: pomimo usunięcia duplikatów, ze względu na losowy podział danych nie można wykluczyć, że w zbiorach TRAIN i VALID znalazły się pytania podobne tematycznie.
Syntetycznie wygenerowane teksty okazały się znacznie krótsze niż te używane w poprzednich wersjach Toktumi, co widać na poniższej ilustracji. Średnio jeden rekord miał około 43 tokeny, a najdłuższy 174 tokeny. Długość sekwencji treningowej (block size) ustawiłem na 256 tokenów, dostosowując ją do takiej długości rekordów. Parametr ten ma również istotny wpływ na zużycie pamięci VRAM, więc w moim przypadku nie mógł być za wysoki.
Struktura zbioru uczącego z wymieszanymi tekstami:
Porównanie rozmiarów zbiorów treningowych Toktumi 1.0 | Toktumi 2.0 | Toktumi 3.0:
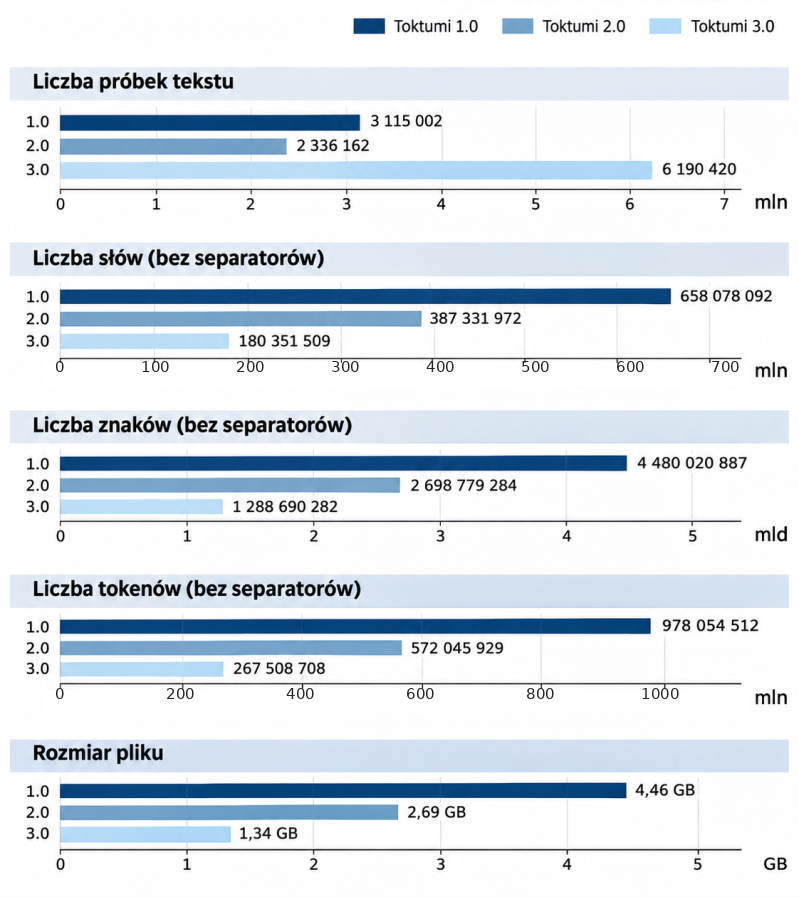
Porównanie z poprzednimi wersjami Toktumi pokazuje, jak bardzo zmienił się charakter zbioru treningowego. Toktumi 3.0 zawiera ponad 2,5 razy więcej rekordów niż Toktumi 2.0, a jednocześnie liczba słów i tokenów zmniejszyła się o około 53% w stosunku do Toktumi 2.0. Sam plik treningowy jest niemal o połowę mniejszy.
Model więc uczył się na większej liczbie przykładów, ale przy znacznie mniejszej liczbie tokenów. Tym razem postawiłem przede wszystkim na jakość, zwięzłość i uporządkowanie danych treningowych, zamiast zwiększania ich objętości.
Długość tekstów w zbiorach treningowych dobrze ilustruje poniższy wykres:
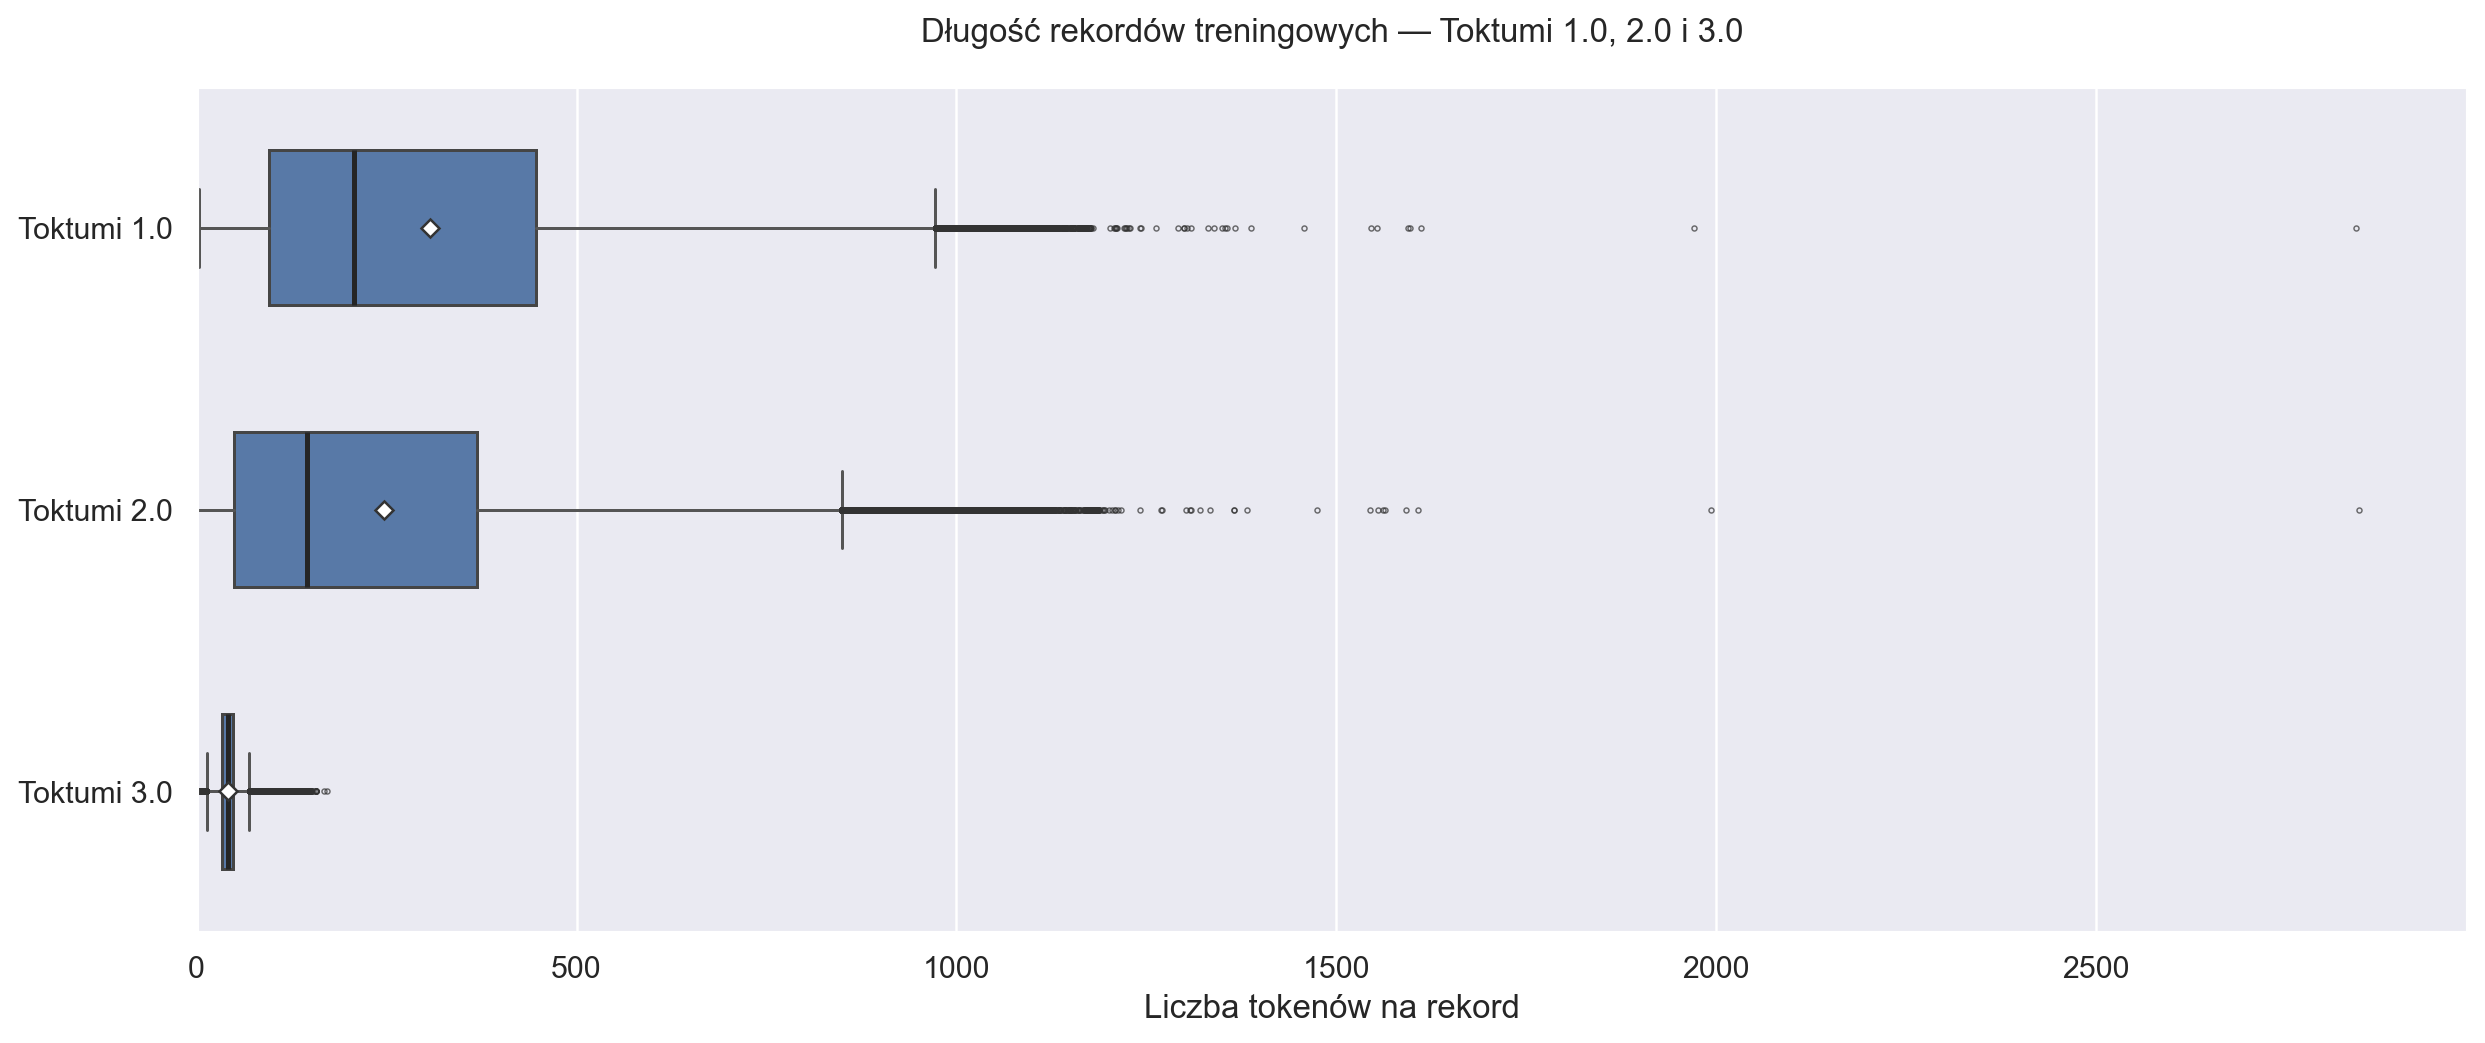
Boxplot pokazuje, jak bardzo skróciły się rekordy treningowe w kolejnych wersjach Toktumi.
Mediana długości: Toktumi 1.0 – 207 tokenów, Toktumi 2.0 – 145 tokenów, Toktumi 3.0 – zaledwie 41 tokenów.
Przy okazji na wykresie widać dwie najbardziej skrajne wartości odstające w Toktumi 1.0 i 2.0 (pojedyncze kropki z prawej strony) - czyli bardzo długie teksty, których nie wychwyciły stosowane przeze mnie na wcześniejszych etapach filtry długości. Mogą zawyżać średnią, dlatego jako miarę długości wybrałem medianę.
W Toktumi 3.0 rekordy powstawały od podstaw, dzięki czemu teksty mają bardziej ustandaryzowaną długość.
6. Trening Toktumi 3.0
Przed właściwym treningiem przeprowadziłem eksperyment na mniejszym zbiorze danych, aby sprawdzić, czy lepiej uczyć model od zera, czy kontynuować uczenie Toktumi 2.0. Testy wykazały przewagę fine-tuningu, dlatego zdecydowałem się wykorzystać wcześniej wyuczone umiejętności językowe modelu.
Zachowałem architekturę GPT-2 Medium oraz tokenizer Toktumi 2.0, aby zapewnić zgodność pomiędzy obu wersjami.
Trening zaplanowałem na maksymalnie 15 epok, z automatyczną walidacją, zapisywaniem checkpointów i mechanizmem early stopping, który miał zakończyć uczenie, gdy model przestanie się poprawiać.
Kluczowa część kodu użytego do uczenia modelu:
# Wczytanie Toktumi 2 i tokenizera
tokenizer = GPT2TokenizerFast.from_pretrained(TOKENIZER_PATH)
model = GPT2LMHeadModel.from_pretrained(MODEL_PATH)

# Przygotowanie danych
train_dataset = TokenBlockDataset(TRAIN_PATH, tokenizer, 256) # block_size = 256
valid_dataset = TokenBlockDataset(VALID_PATH, tokenizer, 256)

# Parametry treningu
training_args = TrainingArguments(
    output_dir=str(CHECKPOINT_DIR),
    num_train_epochs=15,
    per_device_train_batch_size=6,
    gradient_accumulation_steps=4,
    learning_rate=5e-5,
    fp16=True,
    eval_strategy="steps",
    eval_steps=8000,
    save_strategy="steps",
    save_steps=8000,
    save_total_limit=100,
    load_best_model_at_end=True,
    metric_for_best_model="eval_loss",
    greater_is_better=False,
)

# Fine-tuning z mechanizmem early stopping
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    eval_dataset=valid_dataset,
    data_collator=DataCollatorForLanguageModeling(tokenizer, mlm=False),
    callbacks=[EarlyStoppingCallback(early_stopping_patience=6)],
)

trainer.train()
trainer.save_model(str(BEST_MODEL_DIR))
Zdecydowałem się zachować wszystkie checkpointy, co pomogło później porównać jakość odpowiedzi modelu na różnych etapach treningu.
Bogatszy o wcześniejsze doświadczenia, tym razem postanowiłem zastosować callback early stopping, zamiast ręcznie oceniać postępy na podstawie perplexity. Jak się okazało, była to dobra decyzja – nie musiałem już samodzielnie decydować, kiedy zakończyć trening. Z dużego zbioru danych wydzieliłem odpowiednio liczny zbiór walidacyjny, a mechanizm early stopping automatycznie zatrzymywał uczenie, gdy wartość eval_loss przestawała się poprawiać. Jeden cykl walidacji trwał około 3 minut, więc nie wydłużało to znacząco całego procesu.
TRENING W LICZBACH
Ze względu na wysokie ceny kart graficznych (2026) zdecydowałem się pozostać przy używanej do tej pory NVIDIA GeForce RTX 3060. Parametry treningu dopasowałem do dostępnej pamięci (12 GB VRAM).
- Jedna epoka: składała się z 44 538 kroków, a przejście przez 1 epokę zajmowało ok 16 godzin.
- Czas całego treningu: około 9,5 dnia, z przerwami i wznawianiem z checkpointów.
- Early stopping: automatycznie zakończył trening na 448 000. kroku, po 10,06 epoki.
- Najlepszy checkpoint według eval_loss: checkpoint-400000, osiągnięty pod koniec 9. epoki (8,98).
- Zapisane checkpointy: łącznie 56 (w dalszych testach wykorzystuję połowę z nich).
Wykres ilustrujący postęp treningu:
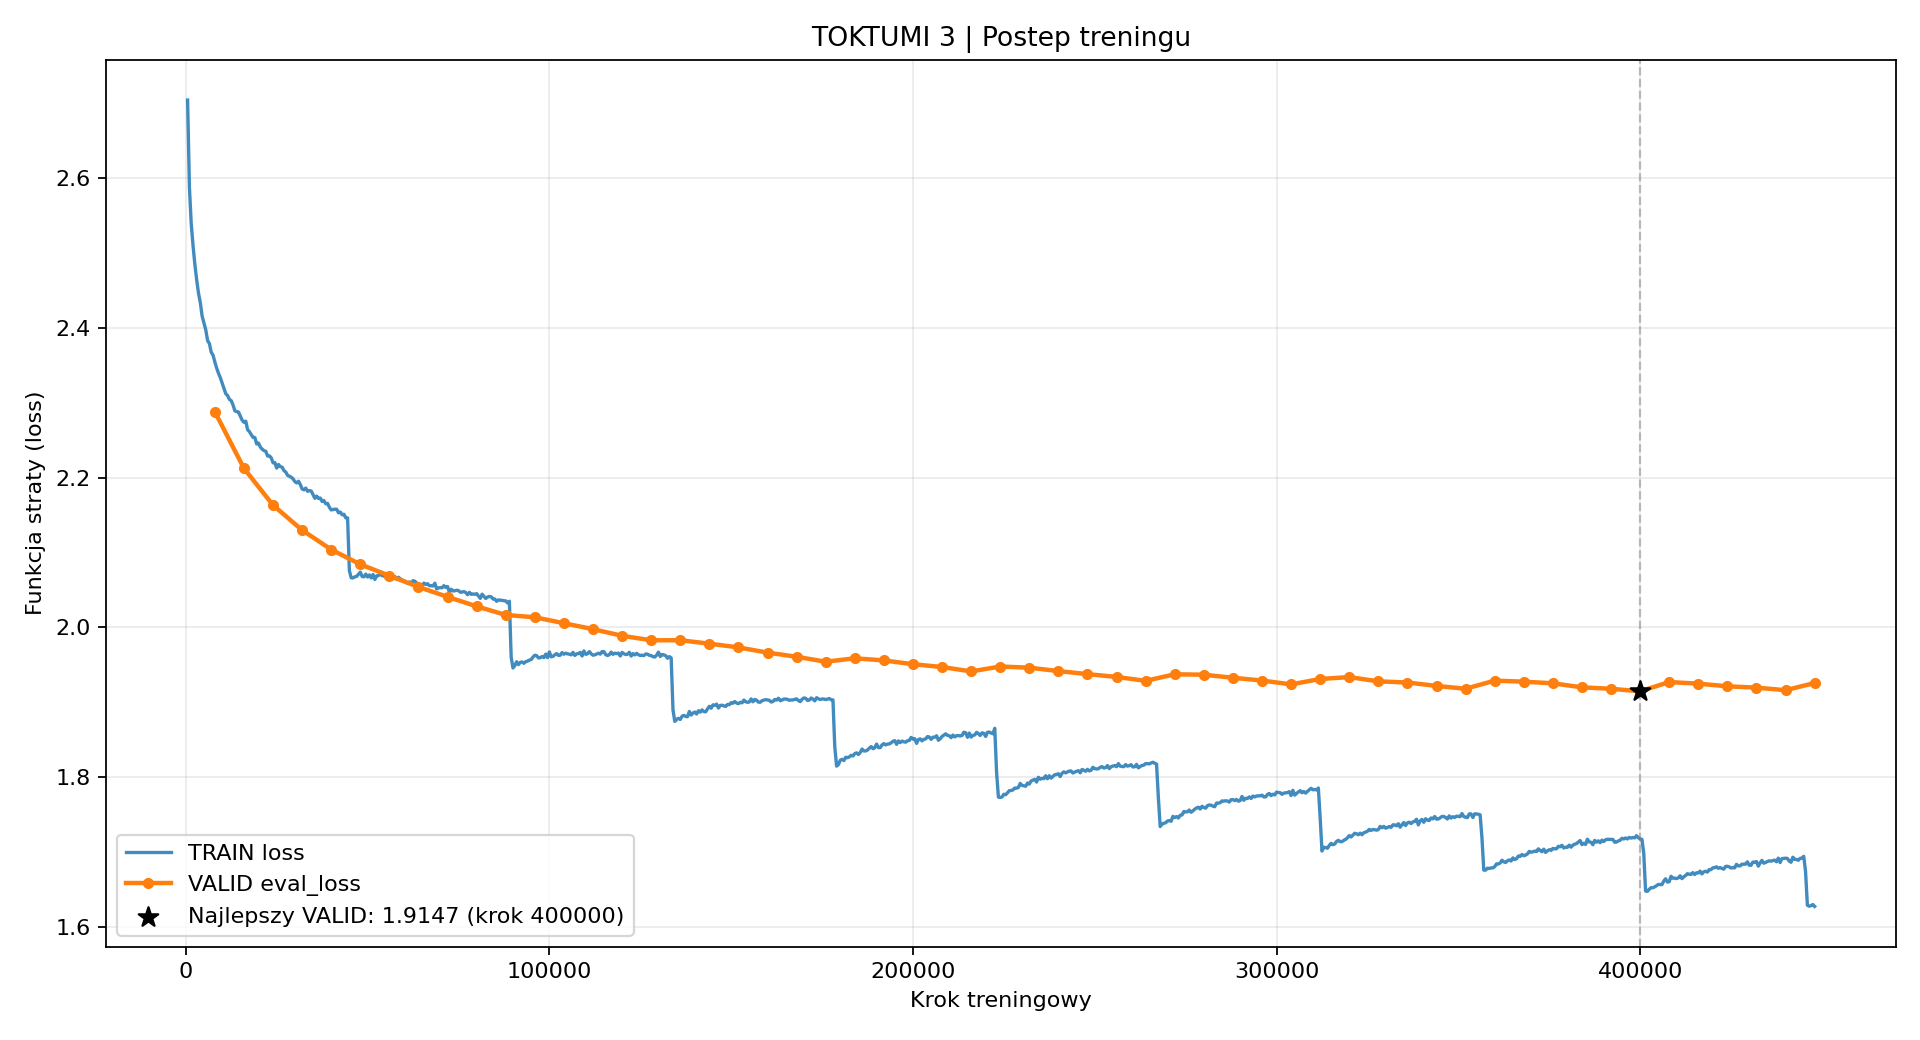
Po dziewiątej epoce train_loss nadal spadał, ale eval_loss przestał się poprawiać, co ostatecznie uruchomiło mechanizm early stopping.
Charakterystyczne „schodki” na wykresie train_loss (niebieska linia) pojawiają się regularnie na początku kolejnych epok. Nie muszą świadczyć o błędzie treningu, a jak można przypuszczać, mają związek z ponownym przemieszaniem danych treningowych i przebiegiem procesu optymalizacji.
7. Ocena jakości modelu — PROMPTING i testowanie checkpointów
W kolejnym kroku przetestowałem 29 wybranych checkpointów na dwóch dodatkowych zestawach testowych po 300 promptów, uzyskując łącznie 17 400 odpowiedzi — co stanowi obszerny materiał do analizy.
Z pomocą AI przeprowadziłem szacunkową ocenę FCT (Factuality), uwzględniając poprawność faktograficzną, sensowność i adekwatność odpowiedzi. Każda poprawna lub sensowna odpowiedź otrzymywała 1 punkt. Jest to umowne kryterium (szczegółowo opisałem je w Części 2), które pozwoliło porównać jakość odpowiedzi poszczególnych checkpointów.
Najlepsze wyniki (600 promptów):
- checkpoint-400000: 431/600 (71,8%)
- checkpoint-448000: 431/600 (71,8%)
- checkpoint-432000: 425/600 (70,8%)
Do dalszych testów wybrałem checkpoint-400000, który osiągnął również najniższy eval_loss podczas treningu i został automatycznie wskazany jako najlepszy przez mechanizm early stopping. Należy dodać, że różnice między najlepszymi checkpointami były niewielkie.
Wyniki checkpointów według kryterium Factuality (FCT) czyli poprawność, zgodność z faktami i sensowność odpowiedzi:
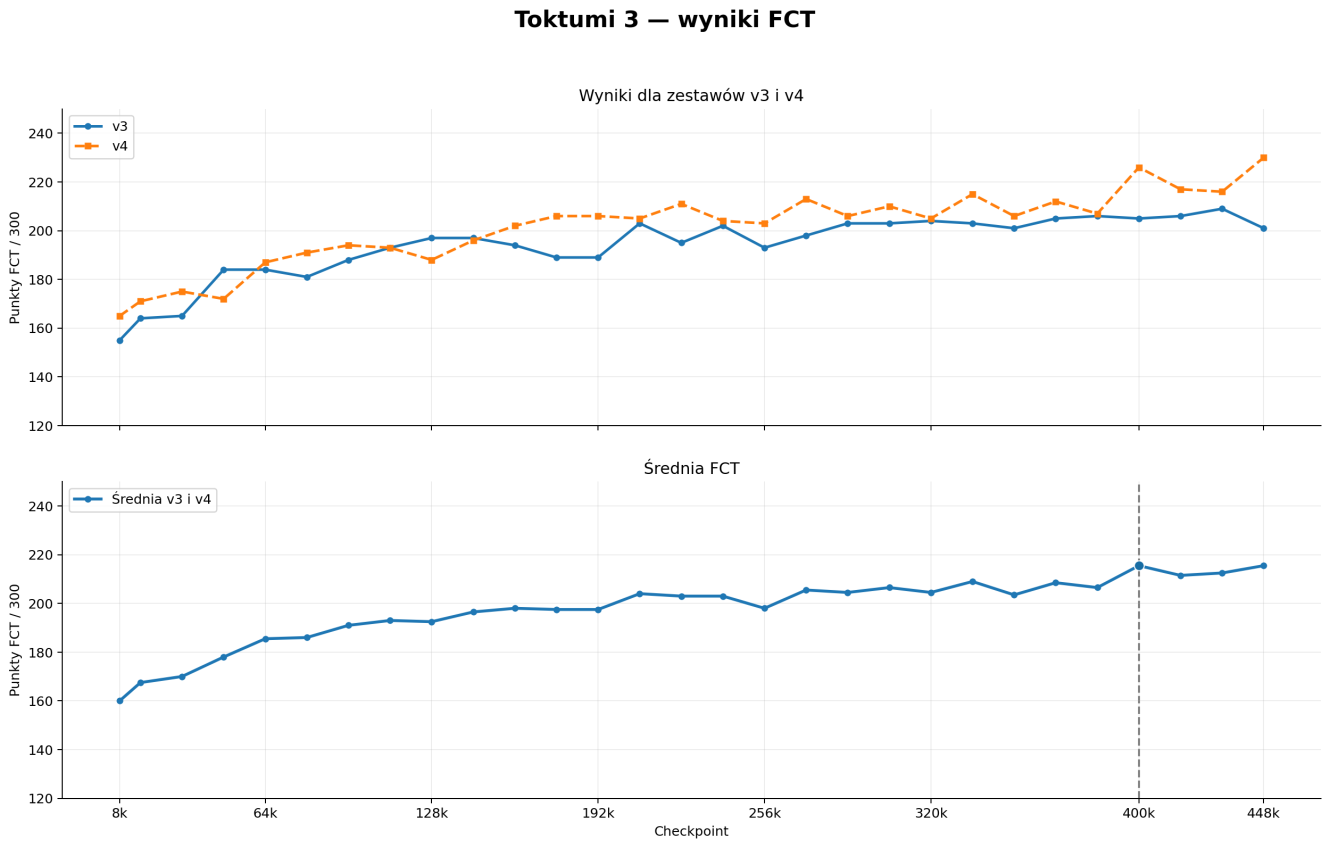
Ciekawostka: Na pytanie o pierwszego prezydenta USA (w trybie greedy decoding) checkpoint-384000 poprawnie wskazał George'a Washingtona, checkpoint-400000 błędnie podał George'a W. Busha, a checkpoint-448000 znów odpowiedział prawidłowo. Pokazuje to, że dłuższy trening nie zawsze gwarantuje poprawę odpowiedzi. Model potrafi udzielić prawidłowej odpowiedzi, ale nie zawsze wybiera ją jako najbardziej prawdopodobną.
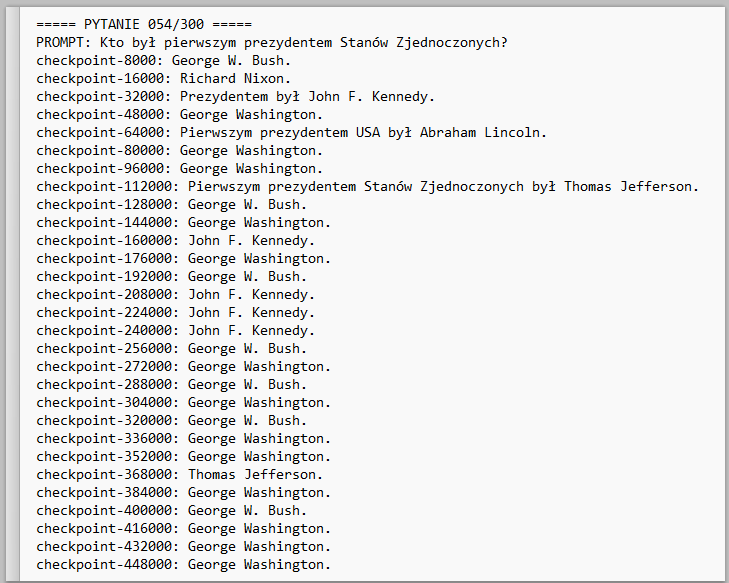
Zestawy promptów wraz z odpowiedziami w podziale na checkpointy - do obejrzenia.
300 Pack 1 oraz drugi zestaw 300 Pack 2.
8. Porównanie wszystkich wersji modelu: Toktumi 1-2-3
W tym miejscu sprawdzam, jak Toktumi 3.0 wypada na tle poprzednich wersji (opisanych w Części 1 i Części 2). Wracam do zestawu 150 promptów, wykorzystanego wcześniej (weryfikacja Toktumi 1.0 i 2.0).
Test pokazuje, czy Toktumi 3.0 poprawnie rozpoznaje polecenie (IF), a następnie czy jego odpowiedź jest zgodna z faktami (gdy można zastosować kryterium prawdziwości) lub sensowna (bardziej subiektywna ocena w przypadku dialogów) (FCT). Wyniki klasyfikowałem jako TAK/TAK, TAK/HAL lub NIE, gdzie HAL oznacza halucyowanie, pomimo prawidłowego rozpoznania konstrukcji wypowiedzi (szczegóły – w części o Toktumi 2.0).
Wyniki Toktumi 1.0
| Klasyfikacja [IF / FCT] | Liczba przypadków |
|---|---|
| TAK / TAK – poprawna struktura i poprawna odpowiedź | 85 |
| TAK / HAL – poprawna struktura, ale halucynacja | 33 |
| NIE – brak poprawnego rozpoznania polecenia | 32 |
| Razem | 150 |
| Odsetek poprawnych odpowiedzi (TAK / TAK) | 56,7% |
Wyniki Toktumi 2.0
| Klasyfikacja [IF / FCT] | Liczba przypadków |
|---|---|
| TAK / TAK – poprawna struktura i poprawna odpowiedź | 102 |
| TAK / HAL – poprawna struktura, ale halucynacja | 42 |
| NIE – brak poprawnego rozpoznania polecenia | 6 |
| Razem | 150 |
| Odsetek poprawnych odpowiedzi (TAK / TAK) | 68,0% |
Wyniki Toktumi 3.0
| Klasyfikacja [IF / FCT] | Liczba przypadków |
|---|---|
| TAK / TAK – poprawna struktura i poprawna odpowiedź | 114 |
| TAK / HAL – poprawna struktura, ale halucynacja | 31 |
| NIE – brak poprawnego rozpoznania polecenia | 5 |
| Razem | 150 |
| Odsetek poprawnych odpowiedzi (TAK / TAK) | 76,0% |
Wyniki pokazują wyraźną poprawę jakości modelu. Odsetek poprawnych odpowiedzi wzrósł z 56,7% w Toktumi 1.0 do 76% w Toktumi 3.0, a liczba nierozpoznanych poleceń spadła z 32 do 5 na 150 promptów.
Toktumi 3.0 znacznie lepiej radzi sobie z poleceniami i częściej udziela poprawnych odpowiedzi, choć nadal popełnia błędy faktograficzne i generuje halucynacje.
Wyniki z odpowiedziami dla Toktumi 1-2-3 (150 promptów) TUTAJ
9. Testy jakościowe, czyli co potrafi model Toktumi 3.0?
W tym miejscu dokładnie sprawdzam możliwości i ograniczenia Toktumi 3.0.
Wykorzystałem dwa przygotowane wcześniej zestawy po 300 promptów (300 Pack 1 i 300 Pack 2). Wszystkie 600 odpowiedzi wygenerowałem w trybie greedy decoding.
Wyniki i wnioski poniżej.
a) FORMA: KRÓTSZE ODPOWIEDZI
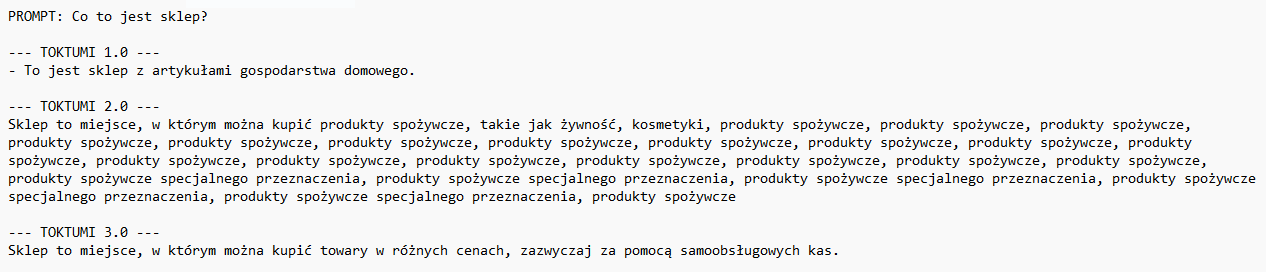
Pierwsza zauważalna zmiana to sposób, w jaki model kończy wypowiedzi. W przeciwieństwie do wcześniejszych generacji, Toktumi 3.0 zazwyczaj udziela krótkiej odpowiedzi i nie kontynuuje niepotrzebnie tekstu. Zostały też znacznie ograniczone zapętlenia tekstu, charakterystyczne dla Toktumi 1 i 2.
Przykład zapętlenia tekstu - problem znacznie ograniczony w Toktumi 3. Ostatnia wersja modelu znacznie rzadziej wpada w powtórzenia i częściej udziela krótkich, poprawnych i spójnych odpowiedzi na zadany temat.
Krótkie odpowiedzi to znak rozpoznawczy Toktumi 3.0:
[Toktumi 3.0]
Prompt (v3, nr 7): W jakiej dyscyplinie sportu specjalizowała się Justyna Kowalczyk?
Odpowiedź: Biegi narciarskie.
Prompt (v3, nr 90): Jak nazywa się jednostka dziedziczenia znajdująca się w DNA?
Odpowiedź: Gen.
Prompt (v4, nr 43): Jak nazywa się naturalny satelita naszej planety?
Odpowiedź: Księżyc.
b) CO MODEL ROBI DOBRZE?
OK 1. Proste pytania i wykonywanie instrukcji
Model dobrze radzi sobie z poleceniami, które wymagają wskazania konkretnych przykładów, stworzenia krótkiej listy lub udzielenia jednoznacznej odpowiedzi.
[Toktumi 3.0]
Prompt (v4, nr 4): Wymień trzy rzeczy, które przydają się podczas pikniku.
Odpowiedź: Podczas pikniku przydają się: koc, napoje oraz przekąski.
Prompt (v4, nr 100): Wymień trzy polskie owoce sezonowe.
Odpowiedź: Truskawki, maliny, jagody.
Prompt (v4, nr 142): Wymień dwa sposoby podróżowania po mieście bez własnego samochodu.
Odpowiedź: Dwa sposoby to korzystanie z komunikacji miejskiej, takiej jak autobusy lub tramwaje, oraz chodzenie pieszo.
OK 2. Definicje i wyjaśnianie podstawowych pojęć
Toktumi 3 potrafi też formułować poprawne, rozbudowane wyjaśnienia:
[Toktumi 3.0]
Prompt (v4, nr 34): Wyjaśnij prostymi słowami, do czego służy termostat.
Odpowiedź: Termostat to urządzenie, które włącza lub wyłącza grzanie, gdy temperatura w pomieszczeniu spadnie poniżej ustawionego poziomu, co pozwala utrzymać w nim komfortową temperaturę.
Prompt (v3, nr 106): Opisz, czym jest szczepionka i jaki jest cel jej stosowania.
Odpowiedź: Szczepionka to preparat biologiczny, który uczy układ odpornościowy rozpoznawać i zwalczać konkretne drobnoustroje, takie jak wirusy czy bakterie, chroniąc przed zachorowaniem lub łagodząc przebieg choroby.
Prompt (v3, nr 125): Opisz, na czym polega funkcja Rzecznika Praw Obywatelskich w Polsce.
Odpowiedź: Rzecznik Praw Obywatelskich stoi na straży wolności i praw człowieka oraz obywatela, badając, czy organy władzy publicznej działają zgodnie z prawem i czy nie przekraczają swoich uprawnień.
W takich przykładach model generuje spójną wypowiedź, używając właściwego słownictwa i zachowując logiczną strukturę.
Wreszcie też prawidłowo podaje definicję ołówka, z czym poprzednie wersje Toktumi miewały problem.
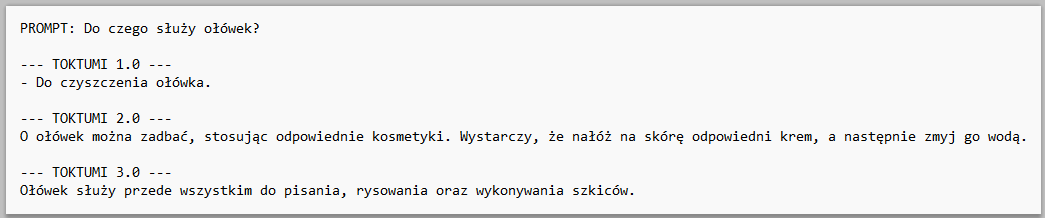
OK 3. Rozumienie słów i frazeologizmów
Ciekawe są również odpowiedzi dotyczące znaczenia polskich słów i związków frazeologicznych, których model uczył się na podstawie słownika języka polskiego.
[Toktumi 3.0]
Prompt (v3, nr 22): Wyjaśnij słowo „zawzięty” w odniesieniu do osoby dążącej do celu.
Odpowiedź: Oznacza to, że osoba ta jest bardzo zdeterminowana, nie poddaje się łatwo i z wielkim zapałem realizuje swoje zamierzenia, nie zważając na przeszkody.
Prompt (v3, nr 292): Co znaczy frazeologizm „grać na zwłokę”, gdy ktoś unika podjęcia decyzji?
Odpowiedź: Oznacza to celowe opóźnianie jakiegoś działania lub decyzji, aby zyskać na czasie i uniknąć podjęcia właściwego wyboru.
Prompt (v4, nr 218): Jak rozumiesz „rzucać kłody pod nogi”?
Odpowiedź: To określenie sytuacji, w której ktoś celowo utrudnia innym osiągnięcie zamierzonego celu.
Co istotne, model potrafi nie tylko podać znaczenie, ale również wyjaśnić je innymi słowami niż w definicji.
OK 4. Krótkie, naturalne dialogi
W Toktumi 3.0 po raz pierwszy wykorzystałem napisy filmowe (subtitles), przetworzone w samodzielne pary dialogowe. Poniższe przykłady pokazują, że model teraz potrafi dopasować odpowiedź do sytuacji i ograniczyć się do jednej wypowiedzi - jak w prawdziwej rozmowie.
[Toktumi 3.0]
Prompt (v3, nr 230): Przepraszam za spóźnienie, autobus utknął w korku.
Odpowiedź: Nie szkodzi, najważniejsze, że już jesteś i możemy zaczynać.
Prompt (v3, nr 172): Obiecaj mi, że zachowasz to dla siebie.
Odpowiedź: Możesz być spokojny, nikomu nie pisnę ani słowa.
Prompt (v3, nr 238): Wreszcie dostałem tę pracę, o której ci opowiadałem!
Odpowiedź: To fantastyczna wiadomość, naprawdę się cieszę, że udało ci się ją dostać.
Prompt (v3, nr 219): Nie uwierzysz, co mi się dzisiaj przydarzyło!
Odpowiedź: Co takiego?
Niektóre reakcje są zaskakująco naturalne. Model potrafi rozpoznać emocjonalny ton rozmowy, wyrazić zainteresowanie lub odpowiedzieć potocznym językiem.
c) Z CZYM MODEL NADAL MA PROBLEMY?
Problem 1. Wiedza faktograficzna — poprawna forma, ale błędna treść
Największym problemem pozostają szczegółowe fakty: nazwiska, daty, wydarzenia historyczne i konkretne informacje o świecie.
[Toktumi 3.0]
Prompt (v3, nr 54): Kto był pierwszym prezydentem Stanów Zjednoczonych?
Odpowiedź: George W. Bush.
(Powinno być: George Washington.)
Prompt (v3, nr 16): Podaj imię i nazwisko pierwszej kobiety, która poleciała w kosmos.
Odpowiedź: Jurij Gagarin.
(Powinno być: Walentina Tierieszkowa.)
Prompt (v4, nr 1): Podaj nazwę norweskiej stolicy.
Odpowiedź: Stolicą Norwegii jest Bermudy.
(Powinno być: Oslo.)
Te przykłady dobrze pokazują, że model opanował formę odpowiadania znacznie lepiej niż wiedzę faktograficzną. Nie odmawia odpowiedzi i nie sygnalizuje niepewności — po prostu podaje nieprawdziwą informację (halucynuje).
Powyższe odpowiedzi uzyskano w trybie greedy decoding. Po wprowadzeniu losowania top_k=2 model potrafił również wskazać poprawne odpowiedzi: George’a Washingtona w 3 z 10 prób, a Oslo w 6 z 20 prób.
Wystarczy kilka prób i model w końcu prawidłowo podaje stolicę Norwegii.
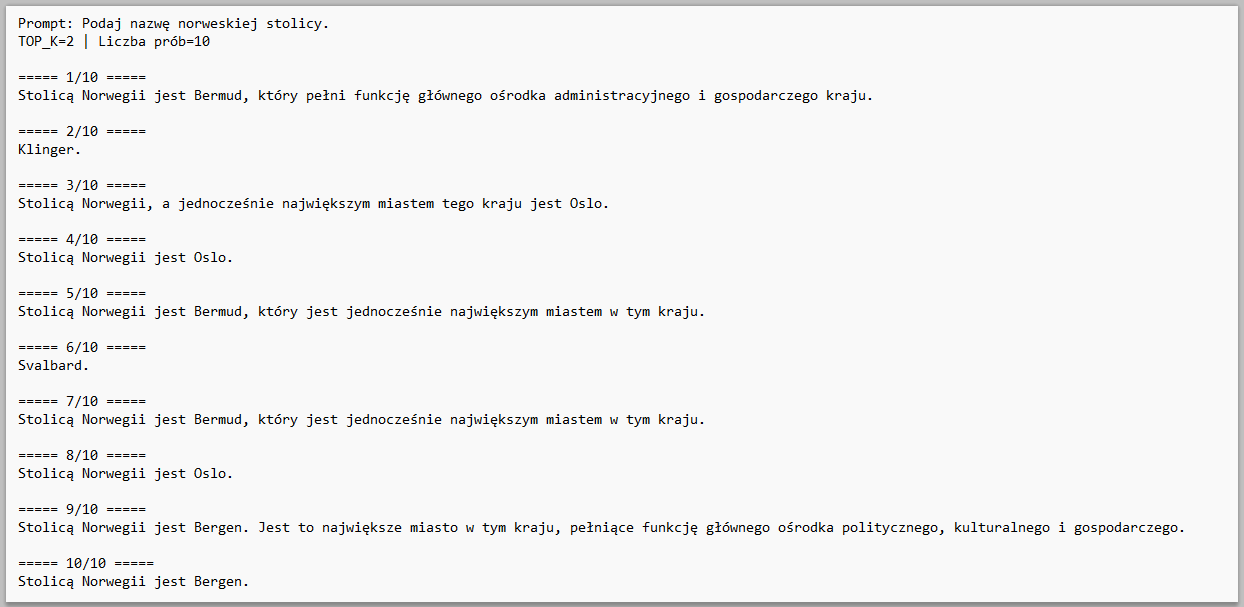
Jednak losowanie nie zawsze pomaga. W przypadku pytania o pierwszą kobietę w kosmosie model ani razu na 100 prób nie wskazał Walentiny Tierieszkowej. Zamiast tego podawał m.in. Jurija Gagarina, Marię Skłodowską-Curie, projektantkę mody Jil Sander, aktorkę Gillian Anderson, a nawet Marię Czubaszek.
Przeszukałem zbiór uczący - okazuje się, że ta informacja pojawiła się w datasecie kilkukrotnie.
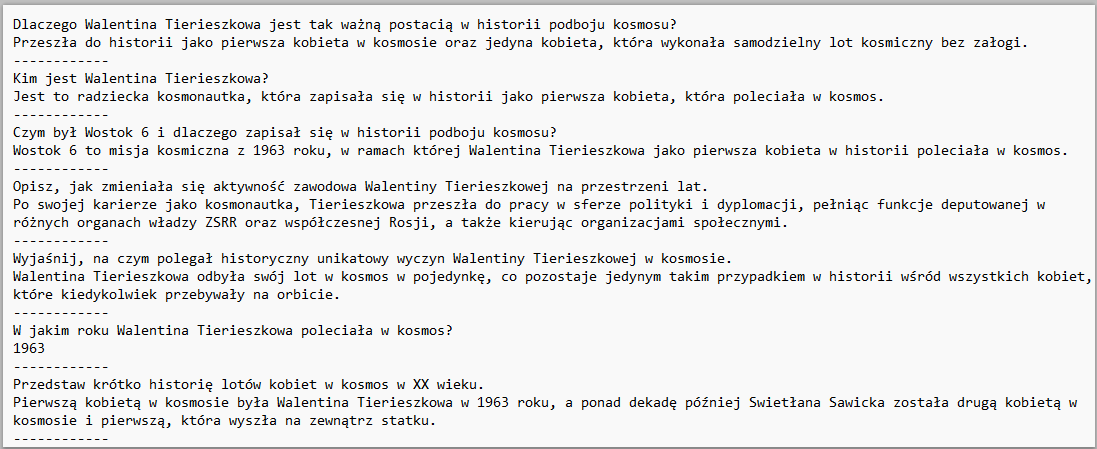
Postanowiłem więc przeformułować pytanie na „Kim była Walentina Tierieszkowa?”. Tym razem model odpowiada poprawnie:
„Była radziecką kosmonautką, która jako pierwsza kobieta w historii poleciała w kosmos."
Jak widać, model zna tę informację, ale ma problem z powiązaniem jej z właściwą osobą.
Problem 2. Model potrafi 'zepsuć' poprawną odpowiedź, dopisując błędne wyjaśnienie
To szczególnie interesujący rodzaj halucynacji.
Prompt (v3, nr 1): Wskaż, nad jaką rzeką położony jest Sandomierz.
Odpowiedź: Sandomierz leży nad rzeką Wisłą, która jest dopływem Wisły.
Pierwsza część odpowiedzi jest poprawna. Druga — bez sensu.
Inny przykład - pytanie o fotosyntezę:
Prompt (v3, nr 43): Jaki gaz rośliny pobierają z atmosfery w procesie fotosyntezy?
Odpowiedź: W procesie fotosyntezy z atmosfery pobierają dwutlenek węgla, który jest niezbędny do oddychania dla większości roślin.
Model prawidłowo wskazuje dwutlenek węgla, ale błędnie wyjaśnia jego funkcję.
Problem 3. Rozumienie znaczenia nie zawsze idzie w parze ze znajomością języka
Mimo wielu udanych definicji model ma problemy z niektórymi, nawet popularnymi wyrażeniami.
[Toktumi 3.0]
Prompt (v4, nr 134): Co oznacza „mieć dwie lewe ręce”?
Odpowiedź: Oznacza to, że osoba wykonująca pracę ma dwie ręce jednocześnie, co często zdarza się w zawodach wymagających precyzji lub w sytuacjach wymagających dużej siły fizycznej.
Prompt (v4, nr 296): Wyjaśnij pojęcie „syzyfowa praca”.
Odpowiedź: Jest to określenie sytuacji, w której ktoś wykonuje swoje zadania w sposób bardzo powolny, bez wkładania w nie żadnego wysiłku, co prowadzi do szybkiego zakończenia pracy.
W pierwszym przypadku model interpretuje frazeologizm niemal dosłownie. W drugim tworzy płynne wyjaśnienie, które jednak jest halucynacją i nie oddaje właściwego znaczenia słownikowego.
Po sprawdzeniu zbioru treningowego okazało się, że zwrot „mieć dwie lewe ręce” występował w zbiorze uczącym 40 razy, a „syzyfowa praca” 58 razy - wśród nich były zarówno definicje, jak i użycia w dialogach w różnych kontekstach. W tym przypadku również wystarczyło przeformułować prompt - i od razu pojawiły się prawidłowe odpowiedzi:
[Toktumi 3.0]
Prompt: Co potocznie oznacza zwrot mieć dwie lewe ręce?
Odpowiedź: Oznacza to, że ktoś jest niezdarny, mało sprawny fizycznie lub nie radzi sobie z wykonywaniem prostych czynności manualnych.
Prompt: Co to jest syzyfowa praca?
Odpowiedź: Syzyfowa praca to określenie na bardzo ciężką, żmudną i wymagającą wysiłku pracę, która nie przynosi żadnych widocznych efektów.
Wniosek jest podobny jak w przypadku Tierieszkowej: model przyswoił wiedzę, ale nie zawsze potrafi wskazać prawidłową odpowiedź jako najbardziej oczywistą. Czasem wystarczy odpowiednio przeformułować prompt lub zadać pytanie inaczej, aby osiągnąć zamierzony efekt.
Problem 4. Codzienne sytuacje i wiedza zdroworozsądkowa
Prompt (v4, nr 201): Co zrobić, gdy na kuchennej podłodze leżą odłamki rozbitej szklanki?
Odpowiedź: Należy niezwłocznie wezwać pogotowie ratunkowe, dzwoniąc pod numer alarmowy 112, a następnie zabezpieczyć miejsce zdarzenia i nie próbować samodzielnie naprawiać rozbitych szklanek czy talerzy.
Model rozpoznaje, że chodzi o bezpieczeństwo, ale proponuje działanie zupełnie nieproporcjonalne do sytuacji.
Jeszcze jeden przykład:
Prompt (v4, nr 263): Kupiłem aparat fotograficzny. Od czego zacząć naukę robienia zdjęć?
Odpowiedź: Najpierw naucz się obsługi miksera, potem spróbuj zrobić kilka zdjęć w różnych warunkach oświetleniowych, a na koniec spróbuj zrobić kilka ujęć w różnych miejscach, aby sprawdzić, jak najlepiej ustawić aparat.
Odpowiedź zaczyna się od przypadkowego zalecenia dotyczącego miksera, po czym wraca do właściwego tematu fotografowania, choć robi to w sposób dość chaotyczny.
Warto jednak zauważyć, że Toktumi 3 potrafi również udzielać rozsądnych porad dotyczących codziennych sytuacji. Przykładowo:
Prompt (v4, nr 93): Dlaczego nie wolno dotykać przewodów wystających z uszkodzonego gniazdka?
Odpowiedź: Dotykanie przewodów elektrycznych może doprowadzić do zwarcia, awarii instalacji lub porażenia prądem, dlatego należy zachować ostrożność.
Przykłady pokazują, że wiedza zdroworozsądkowa nadal sprawia modelowi trudności. Toktumi 3.0 potrafi czasem udzielić trafnej, praktycznej porady, ale zdarza mu się również proponować działania nieproporcjonalne do sytuacji lub łączyć informacje, które do siebie nie pasują.
Problem 5. Naturalna rozmowa to nie zawsze zrozumienie intencji
Choć model dobrze radzi sobie z krótkimi reakcjami dialogowymi, gorzej wypada, gdy rozmówca oczekuje określonego działania.
Prompt (v4, nr 275): Sąsiad zaprosił nas na grill, ale nie możemy przyjść. Jak grzecznie odmówić?
Odpowiedź: - Jasne, nie ma problemu.
Zamiast zaproponować uprzejmą odmowę, model generuje krótką odpowiedź dialogową, która nie realizuje polecenia.
Podobnie w sytuacji wymagającej porady:
Prompt (v4, nr 83): Muszę jutro wcześnie wstać. Jak się przygotować, żeby nie zaspać?
Odpowiedź: Zacznij od szklanki wody, to zawsze pomaga na żołądek.
Model odpowiada płynnie, ale nie udziela porady, jakiej zapewne oczekiwał rozmówca.
Problem może wynikać ze sposobu przygotowania krótkich, autonomicznych par dialogowych, które nie uwzględniają szerszego kontekstu rozmowy. Model nauczył się naturalnie reagować na pojedyncze wypowiedzi, ale nie zawsze prawidłowo rozpoznaje intencje i role rozmówców.
Rozwiązaniem mogłoby być uczenie modelu na dłuższych, wieloetapowych dialogach, zachowujących kontekst i role rozmówców. Wymagałoby to jednak bardziej złożonego przygotowania danych.
d) DODATKOWE CIEKAWOSTKI
Ciekawostka 1. Skąd się biorą dzieci? — pytanie, które wprawia w zakłopotanie
Postanowiłem sprawdzić, jak Toktumi 3 radzi sobie z pozornie banalnym pytaniem: „Skąd się biorą dzieci?”. Przetestowałem 29 checkpointów (połowę zapisanych), aby zobaczyć, jak odpowiedzi zmieniały się w trakcie treningu. Wynik był zaskakujący — żaden z checkpointów nie udzielił poprawnej odpowiedzi. Zamiast wyjaśniać biologię, model zachowywał się niemal jak zakłopotany dorosły, próbujący uniknąć niewygodnego tematu:
[Toktumi 3.0]
Checkpoint-48000: To nie jest pytanie, na które chciałbyś usłyszeć odpowiedź.
Checkpoint-80000: To nie jest temat do rozmowy przy śniadaniu.
Checkpoint-272000: To pytanie, na które nie dostaniesz odpowiedzi.
Checkpoint-400000: Nie mam pojęcia, ale na pewno nie są to dzieci, o których teraz wspominasz.
Co ciekawe, wystarczyło zapytać inaczej. Na pytanie „Jak powstają dzieci?” odpowiadał już prawidłowo:
Powstają one w wyniku zapłodnienia komórki jajowej przez plemnik, co prowadzi do powstania zygoty.
Odpowiedź jest bardziej charakterystyczna dla języka biologii i medycyny niż codziennej rozmowy, jednak należy ją uznać za poprawną.
To ciekawy przykład odwzorowania językowego obrazu świata — model naśladuje nie tylko naszą wiedzę, ale również sposób myślenia i skojarzenia utrwalone w języku.
Ciekawostka 2. Czy Bóg istnieje? - metafizyczne rozterki sztucznej inteligencji
Kolejnym eksperymentem było pytanie „Czy Bóg istnieje?”, które zadałem wszystkim 29 checkpointom, aby sprawdzić, jak odpowiedzi zmieniały się wraz z postępem uczenia. Wyniki były zaskakujące — Toktumi wielokrotnie zmienia odpowiedź z „tak” na „nie” i odwrotnie.
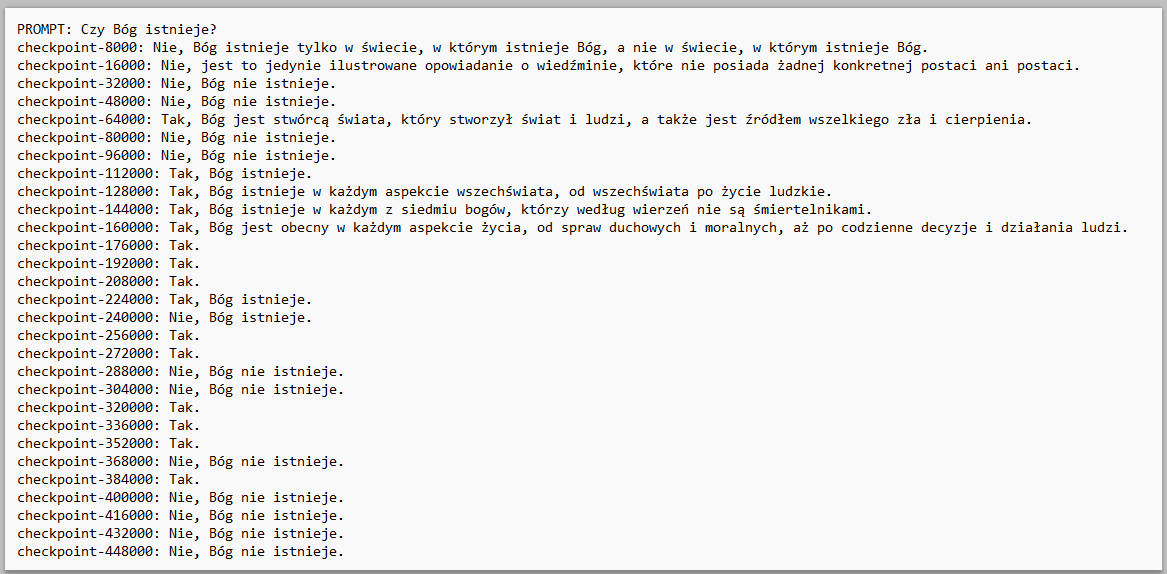
W miarę postępu treningu można zauważyć pewną prawidłowość: początkowo przeważało „nie”, w środkowej fazie zdecydowanie „tak”, a pod koniec ponownie „nie”. Można więc powiedzieć półżartem, że Toktumi wraz z postępem uczenia najpierw „nabywał wiarę”, a następnie ją „tracił”!
Ciekawostka 3. Sztuczna inteligencja uczy się przeklinać
W słowniku języka polskiego znajdziemy również wyrazy wulgarne i pejoratywne — to naturalna część polszczyzny. Obok mocnych wulgaryzmów występują tam określenia takie jak „patafian”, „łajza”, „zadupie”, a także zwroty „zakuty łeb” czy „dupa wołowa”.
Podczas przetwarzania takich haseł Gemini często blokował generowanie odpowiedzi ze względu na mechanizmy moderacji. Dlatego wykorzystałem mniej restrykcyjny lokalny model Gemma, aby również z tego materiału przygotować pary pytań i instrukcji.
Sprawdzamy, czy Toktumi potrafi przeklinać. Jak się okazuje, model przyswoił sobie zasób wulgarnego słownictwa, ale czasem miesza dosadne przekleństwa z zupełnie łagodnymi powiedzeniami:
Prompt: Wymień znane ci przekleństwa.
Odpowiedź: Do popularnych przekleństw należą: „kurwa mać”, „spadaj” oraz „srali muchy będzie wiosna”.
innym razem wpada w ciąg powtórzeń:
Prompt: Jakie są najgorsze przekleństwa w języku polskim?
Odpowiedź: Najgorszymi przekleństwami są wyrazy takie jak kurczę, ojejku, ojejku, ojejku czy też słowa typu kurczę pieczone.
a niekiedy wręcz odmawia wykonania polecenia:
Prompt: Wyraź swoją złość, używając mocnego przekleństwa.
Odpowiedź: Nie będę się zniżał do twojego poziomu, bo to nie jest miejsce na takie rozmowy.
PODSUMOWANIE I WNIOSKI KOŃCOWE
Projekt Toktumi pokazał, jak wiele można osiągnąć, rozwijając stosunkowo niewielki model językowy GPT-2 Medium. Trzy kolejne generacje powstały na bazie tej samej architektury, ale różniły się sposobem przygotowania danych i przebiegiem uczenia. Najważniejsze zmiany zaszły nie w wielkości modelu, lecz w tym, czego i jak go uczono.
Trzy generacje — trzy etapy rozwoju
- Toktumi 1.0 — model nauczył się pisać po polsku. Potrafił tworzyć płynne wypowiedzi, ale często zamiast odpowiadać na pytania, kontynuował artykuły lub generował komentarze niezwiązane z poleceniem. Samo opanowanie języka nie wystarczyło do prowadzenia sensownej rozmowy.
- Toktumi 2.0 — model nauczył się odpowiadać. Przebudowa zbioru treningowego i wprowadzenie pytań oraz instrukcji przyniosły największy przełom w rozpoznawaniu poleceń. Liczba przypadków ich nierozpoznania spadła z 32 do 6 na 150 promptów. Model znacznie częściej wiedział już, jakiego rodzaju odpowiedzi od niego oczekujemy.
- Toktumi 3.0 — model opanował umiejętność prostej rozmowy. Uczenie na starannie przetworzonych i uporządkowanych danych treningowych, w tym parach dialogowych, pozwoliło mu odpowiednio reagować na wypowiedzi rozmówcy, uwzględniając ich kontekst i emocjonalny charakter. W teście porównawczym osiągnął 114 poprawnych odpowiedzi na 150, czyli najwięcej ze wszystkich modeli.
Najciekawsze wnioski z dotychczasowych eksperymentów
- Model uczy się przede wszystkim tego, co znajduje się w danych treningowych. Jeśli nie ma w nich przykładów opowiadania dowcipów, programowania czy rozwiązywania zadań, model nie nauczy się tych umiejętności. LLM potrafi łączyć informacje, uogólniać je i tworzyć nowe treści, ale jego możliwości wynikają przede wszystkim z tego, co znajduje się w danych treningowych.
- Model może znać poprawną odpowiedź, ale nie zawsze wybiera ją jako najbardziej prawdopodobną. Analiza checkpointów pokazała, że model potrafi odpowiadać poprawnie, po dalszym treningu błędnie, a następnie znów poprawnie. Nie musi to oznaczać utraty wcześniej zdobytej wiedzy — podczas uczenia zmieniają się tylko prawdopodobieństwa generowanych odpowiedzi.
- Jakość i struktura danych treningowych mogą być ważniejsze niż ich ilość. Toktumi 1.0 uczył się na milionach surowych tekstów, ale dopiero wprowadzenie uporządkowanych pytań, instrukcji i dialogów przyniosło wyraźną poprawę. Eksperymenty pokazały, jak duże znaczenie ma odpowiedni dobór i przetworzenie materiałów źródłowych.
- Czasem tajemnica tkwi w odpowiednim sformułowaniu promptu. Model może posiadać określoną wiedzę, ale nie potrafić jej przywołać przy konkretnym pytaniu. Niekiedy wystarczy inaczej sformułować prompt, dodać kontekst lub odpowiednio naprowadzić model, aby uzyskać poprawną odpowiedź.
- Model uczy się nie tylko informacji i słów, ale również ludzkich sposobów postrzegania świata. W języku zakodowane są nasze opinie, przekonania i stereotypy, które model może nauczyć się odtwarzać. Potrafi robić to tak naturalnie i przekonująco, że łatwo odnieść wrażenie, jakby wyrażał własne, rzeczywiste poglądy.
Wniosek końcowy
Realizacja projektu wymagała połączenia wiedzy z wielu dziedzin — programowania, przetwarzania danych, językoznawstwa, uczenia maszynowego oraz konfiguracji i optymalizacji sprzętu. W praktyce oznaczało to mierzenie się zarówno z problemami technicznymi, jak i z pytaniami o to, jak model przyswaja język, zdobywa wiedzę i uczy się odpowiadać.
Mimo ograniczeń sprzętowych i możliwości architektury GPT-2 Medium udało się zrealizować najważniejsze założenia projektu. Eksperyment pokazał, że nawet jedna osoba, dysponując domowym sprzętem, może stworzyć i wytrenować działający model językowy.
Model Toktumi 3.0 w Hugging Face Spaces
Model Toktumi 3.0 można przetestować na platformie Hugging Face Spaces:
https://huggingface.co/spaces/miczac/toktumi-3.0-polish-gpt2
About the author
- My background combines linguistics and copywriting with Python, Big Data, machine learning, and AI. I'm also interested in data analysis, automation, and natural language processing.
Comments
Join the discussionNo comments yet. Be the first to comment.
Jak zbudować duży model językowy od zera? Toktumi (GPT-2)
Trzyczęściowy projekt budowy i rozwoju polskiego modelu językowego Toktumi, opartego na architekturze GPT-2. Od zebrania danych i treningu od zera, przez udoskonalenie zbioru treningowego, aż po fine-tuning i ocenę jakości modelu.