Jak zbudować duży model językowy od zera? Toktumi 2.0 – Część 2/3
Toktumi 2.0 – polski model LLM oparty na GPT-2. Jak wyciągnąć wnioski z pierwszego treningu i zrobić to lepiej.
ROZDZIAŁ II. Toktumi 2.0. Drugi trening.
W tej części opisuję drugi etap projektu Toktumi, który ma charakter edukacyjno-badawczy i niekomercyjny. Wprowadzam w nim poprawki wynikające z doświadczeń i wniosków z treningu Toktumi 1.0.
Dla przypomnienia: W poprzednim etapie stworzyłem i wytrenowałem od podstaw polskojęzyczny model GPT-2 Medium, wykorzystując 3 115 002 próbki własnoręcznie zebranych i oczyszczonych tekstów. Przygotowałem własny tokenizer, przeprowadziłem trening i testy jakości odpowiedzi. W efekcie Toktumi 1.0 nauczył się generować poprawne językowo teksty, jednak często miał problemy z rozpoznawaniem poleceń i udzielaniem poprawnych odpowiedzi.
Po więcej szczegółów odsyłam do Części 1.
1. Cel ponownego treningu
Postanowiłem ponownie wytrenować model od podstaw. Celem było wdrożenie dwóch kluczowych rekomendacji:
- Usunięcie komentarzy internetowych ze zbioru treningowego, co - jak przypuszczałem - pozwoli wyeliminować treści chaotyczne i niskiej jakości.
- Dodanie zestawów typu Pytanie-Odpowiedź (QA) oraz Instrukcja-Odpowiedź (IA), aby model lepiej uczył się interakcji z użytkownikiem i generował spójne odpowiedzi na konkretne prompty i polecenia.
Fine tuning czy ponowne uczenie?
Zamiast fine-tuningu (dalszego uczenia już wytrenowanego modelu), zdecydowałem się na pełne ponowne uczenie. Wynikało to z obawy, że fine-tuning nie wyeliminuje problemów obecnych w pierwotnym zbiorze danych. Trening od zera pozwala zbudować model w oparciu wyłącznie o oczyszczony i właściwie przygotowany korpus tekstów, co zwiększa kontrolę nad jakością uzyskanego rezultatu.
Ponieważ proces trenowania modelu został już wcześniej przeprowadzony w całości, druga iteracja okazała się prostsza i mniej czasochłonna. Wiele elementów można było powtórzyć bez większych modyfikacji, a konieczne poprawki wprowadzić tylko tam, gdzie to konieczne. Tak jak za pierwszym razem, największym wyzwaniem okazało się przygotowanie nowych tekstów do uczenia modelu, tym razem w formie par pytań i instrukcji z odpowiedziami.
2. Zaplanowanie kolejnych etapów
2a. Zebranie nowych danych - przygotowanie zestawów typu Pytanie-Odpowiedź (QA) oraz Instrukcja-Odpowiedź (IA).
2b. Stworzenie pełnego zbioru treningowego.
2c. Trening od podstaw - przeprowadzenie pełnego uczenia w architekturze GPT-2 Medium, wykorzystując poprawiony zbiór tekstów.
2d. Ocena jakości modelu - etap 1 - pomiar perplexity checkpointów.
2e. Ocena jakości modelu - etap 2 - prompting, weryfikacja ludzka.
2f. Zakończenie treningu na wybranym checkpoincie.
2a. Zebranie danych. Zestawy Pytanie-Odpowiedź (QA), Instrukcja-Odpowiedź (IA)
Tę część rozpocząłem na początku 2025 roku. Nie znalazłem wówczas w sieci rozbudowanych zestawów instrukcji w języku polskim – choć były dostępne w innych językach - głównie po angielsku, np. databricks-dolly-15k (15 tys. przykładów, angielski), HuggingFaceH4 helpful-instructions (150 tys. przykładów, angielski), OIG: Open Instruction Generalist (44 mln przykładów, angielski), Aya Dataset (513 mln przykładów w ponad 100 językach, ale w języku polskim jest ich stosunkowo niewiele).
W tym wypadku kuszącym rozwiązaniem wydawało się wygenerowanie takich danych samodzielnie, przy pomocy istniejących modeli LLM. Tego typu podejście bywa określane jako generowanie danych syntetycznych (synthetic data). Więcej na ten temat [Artykuł].
Zdecydowałem się przeprowadzić dwa eksperymenty:
- Generowanie lokalnie na domowym PC z użyciem modelu Mistral-Nemo-12B-Instruct-2407 pobranego z serwisu Hugging Face - obsługę promptów kontrolowałem z poziomu Pythona.
- Generowanie z użyciem Gemini API (model Google), co pozwoliło mi nie tylko zebrać dane, ale także poćwiczyć integrację Pythona z zewnętrznym API i porównać jakość wyników. Użyłem modelu gemini-2.5-flash.
Oba podejścia miały swoje zalety i ograniczenia. Model Mistral, uruchamiany lokalnie, zapewniał pełną kontrolę nad procesem i uniezależniał od usług zewnętrznych. Wadą były jednak ograniczenia sprzętowe (GeForce RTX 3060), co wiązało się z długim czasem generowania oraz znacznym zużyciem energii - większym niż w przypadku samego trenowania modelu.
Z kolei model Gemini, dostępny w chmurze, jest szybszy, prostszy w obsłudze i generuje bardziej dopracowane językowo odpowiedzi. Wadą tego rozwiązania są jednak ograniczenia i limity narzucone przez API, które utrudniały generowanie tekstów na dużą skalę. Alternatywą było korzystanie z płatnego dostępu, jednak przy tak dużej liczbie tekstów koszty byłyby zbyt wysokie w stosunku do ograniczonego budżetu projektu.
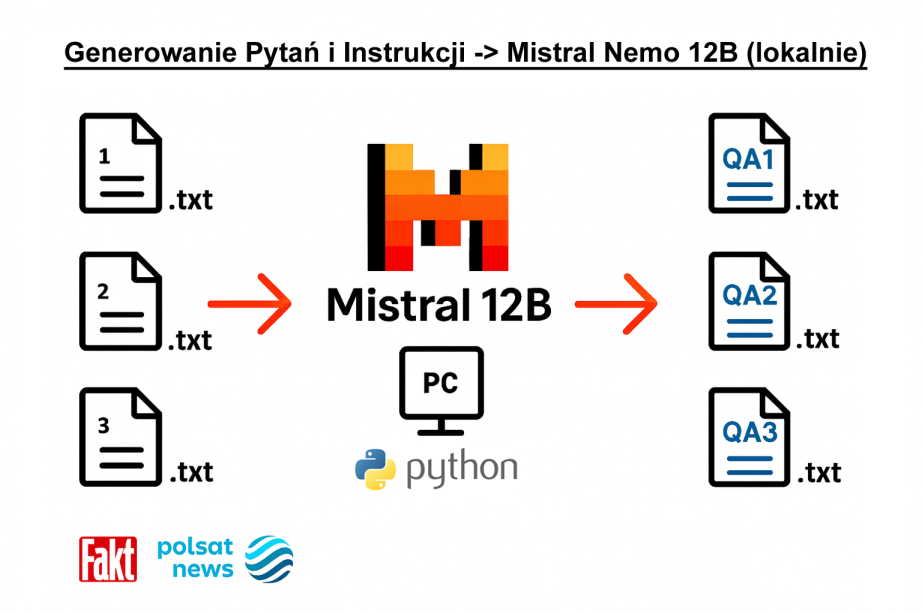
ZESTAWY INSTRUKCJI GENEROWANE LOKALNIE (MISTRAL NEMO 12B)
Do generowania zestawów typu Pytanie-Odpowiedź (QA) oraz Instrukcja-Odpowiedź (IA) wykorzystałem model Mistral-Nemo-12B-Instruct-2407, uruchamiany lokalnie na domowym PC.
Sposób działania kodu: W katalogu roboczym znajdowały się pliki tekstowe (.txt) z artykułami o różnorodnej tematyce, pozyskane wcześniej z serwisów fakt.pl oraz polsatnews.pl. Każdy z tekstów przekazywałem do modelu wraz z rozbudowanym promptem, który precyzyjnie określał oczekiwany format wyjściowy (pytania i instrukcje wraz z odpowiedziami). Było to zarazem ciekawe ćwiczenie z zakresu prompt engineeringu. W przypadku modelu Mistral 12B kluczowe znaczenie miało dopracowanie treści promptu - dopiero rozbudowane testy przyniosły zadowalający efekt.
Wraz z promptem model dostaje następujące zadanie:
- wygeneruj maksymalnie pięć pytań różniących się strukturą i długością, wraz z odpowiedziami,
- ogranicz pytania zamknięte typu „tak/nie” (model miał skłonność do nadużywania tego formatu),
- wygeneruj różne warianty instrukcji na temat danego artykułu,
- posługuj się wyłącznie poprawną, płynną polszczyzną,
- unikaj dodatkowych komentarzy i oznaczeń (np. gwiazdek czy myślników), które Mistral jednak okazjonalnie wciąż wprowadzał.
Tak przygotowany proces pozwalał automatycznie tworzyć gotowe zestawy par tekstowych. Poniżej fragment kodu użytego do przetworzenia przykładowego artykułu.
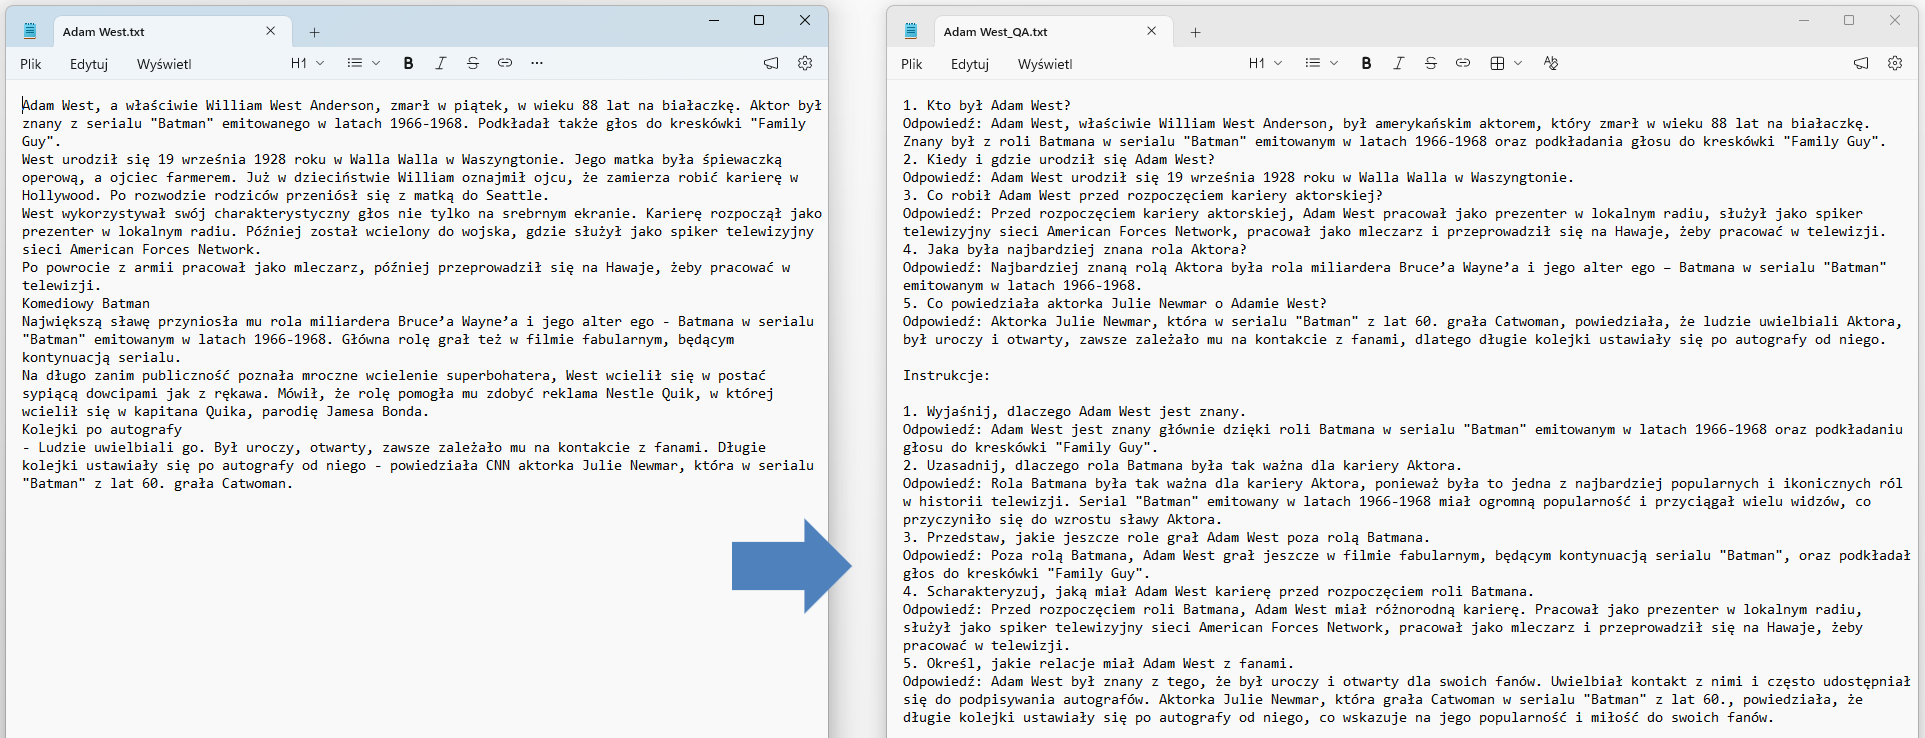
Przykład: Oryginalny tekst przetwarzany na zestaw pytań i instrukcji.
Kod do generowania zestawów wczytuje artykuł, przekazuje go do modelu wraz z przygotowanym promptem, a następnie generuje odpowiedzi. Ze względu na ograniczenia sprzętowe, wykorzystałem też kwantyzację 4-bitową. Więcej o kwantyzacji.
import random
import torch
from time import time
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig

# Model i plik źródłowy
model_id = "Mistral-Nemo-12B-Instruct-2407"
input_file = "sample.txt"

# Kwantyzacja 4-bitowa
quant_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_compute_dtype=torch.float16,
    bnb_4bit_use_double_quant=True,
    bnb_4bit_quant_type="nf4"
)

# Wczytanie modelu i tokenizera
tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    quantization_config=quant_config
).eval()

# Wczytanie artykułu
with open(input_file, "r", encoding="utf-8") as f:
    text = f.read().strip()

# Losowanie czasowników do przykładów instrukcji
verbs = [
    "Opisz", "Streść", "Wyjaśnij", "Wymień", "Znajdź",
    "Podaj", "Napisz", "Wylicz", "Przeanalizuj",
    "Określ", "Uzasadnij", "Przedstaw", "Oceń",
    "Scharakteryzuj", "Wskaż", "Zdefiniuj", "Porównaj",
    "Zaproponuj", "Uporządkuj", "Powiedz", "Opowiedz"
]

random.shuffle(verbs)
examples = ", ".join(verbs[:7])

# Prompt — pełna treść przedstawiona poniżej
prompt_template = """treść promptu"""
prompt = prompt_template.format(examples=examples, text=text)

# Przygotowanie wejścia dla modelu
messages = [
    {"role": "system", "content": ""},
    {"role": "user", "content": prompt.strip()}
]

chat_input = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,
    return_tensors="pt"
).to(model.device)

# Generowanie pytań, instrukcji i odpowiedzi
start_time = time()

with torch.inference_mode():
    outputs = model.generate(
        chat_input,
        max_new_tokens=1024,
        do_sample=True,
        temperature=0.4,
        top_p=0.7
    )

# Dekodowanie samej wygenerowanej odpowiedzi
generated_ids = outputs[0][chat_input.shape[-1]:]
result = tokenizer.decode(generated_ids, skip_special_tokens=True).strip()

print(result)
print(f"Czas generowania: {time() - start_time:.2f} s")
Kluczowym elementem jest treść promptu (sformułowanego po polsku, który Mistral obsługuje):
Zadaj maksymalnie 5 pytań, na które odpowiedzi znajdują się w treści. Pytania muszą być różnorodne pod względem struktury i długości. Nie wolno zadawać więcej niż jednego pytania, które zaczyna się od „Czy”. Nie zadawaj więcej niż jednego pytania, którego odpowiedź mogłaby być „tak” lub „nie”. Zabronione jest powtarzanie pytań. Pod pytaniem zawsze napisz odpowiedź. Odpowiedź ma być tak szczegółowa, jak to potrzebne.
Następnie stwórz kilka przykładowych tekstów instrukcji w kontekście treści tego tekstu (format imperativus, np. {examples}). To tylko przykłady, wybierz takie, które najbardziej będą pasować do tekstu. Staraj się, aby teksty instrukcji były różnorodne i różniły się między sobą. Zabronione jest powtarzanie instrukcji. Pod instrukcją zawsze napisz odpowiedź. Odpowiedzi powinny być różnorodne.
Uwagi do całego tekstu, który stworzysz: Pisz tylko i wyłącznie w języku polskim. Pisz płynną, poprawną polszczyzną. Nie oznaczaj tekstu dodatkowymi komentarzami od siebie. Nigdy nie stosuj gwiazdek '*', '**' ani myślników '-' w celu wyróżnienia tekstu. Chcę mieć czysty tekst gotowy do użycia: pytanie-odpowiedź, instrukcja-odpowiedź. Nie dodawaj nic więcej. Zapisz wszystko jako ciąg pytań i odpowiedzi oddzielonych pustymi liniami.
Tekst: {text}
Prompt musiał obejmować takie szczegóły, ponieważ jak pokazały testy, model szedł po linii najmniejszego oporu i miał tendencję do tworzenia powtarzalnych konstrukcji, często zaczynających się od „Czy”. Dlatego w prompcie wprowadziłem ograniczenie liczby takich sformułowań.
Poza tym, przy tworzeniu instrukcji zastosowałem prostą sztuczkę z wykorzystaniem zmiennej {examples}. Model miał tendencję do generowania monotonnych, powtarzających się poleceń. Wytypowałem więc 21 czasowników, które najlepiej sprawdzały się w tym zadaniu. Następnie dla każdego artykułu losowałem 7 z nich i podsuwałem modelowi jako przykłady w prompcie. Testy pokazały, że był to najskuteczniejszy sposób na zwiększenie różnorodności generowanych instrukcji, zarówno w przypadku lokalnego Mistrala, jak i Gemini API.
MISTRAL - UZYSKANE WYNIKI:
Kod poprawnie przekształcał tekst źródłowy w zestaw pytań i instrukcji wraz z odpowiedziami. Proces generowania był jednak stosunkowo czasochłonny — na mojej karcie graficznej zajmował średnio około 1 min na artykuł.
Przy zastosowaniu kwantyzacji 4-bitowej w generowanych tekstach pojawiały się drobne niedoróbki językowe, np. „Kto był Adam West?” zamiast „Kim był Adam West?”. W przypadku lokalnego modelu Mistral tego rodzaju konstrukcje występowały stosunkowo często, co wpływało na jakość zbioru treningowego. Pomimo tego, metoda dobrze spełniała swoje zadanie.
Test z Mistralem był wartościowym eksperymentem, ukazującym zarówno potencjał, jak i ograniczenia pracy z dużymi modelami uruchamianymi lokalnie.
ZESTAWY INSTRUKCJI GENEROWANE ONLINE, ZA POMOCĄ GEMINI API (GOOGLE)
W ramach drugiego eksperymentu wykorzystałem popularny w tamtym okresie (2025) model Gemini 2.5 Flash opracowany przez Google, dostępny przez API. Takie rozwiązanie pozwala na integrację modelu z Pythonem i automatyzację generowania tekstów, w tym seryjne przetwarzanie wielu plików.
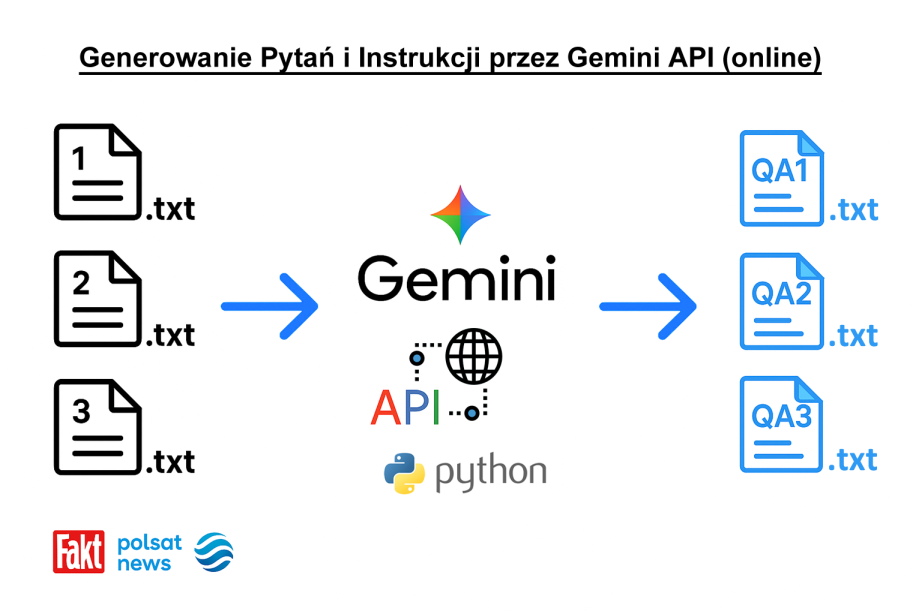
Podobnie jak w przypadku Mistrala, przetwarzałem artykuły źródłowe na zestawy pytań i instrukcji wraz z odpowiedziami. Różnica polega na tym, że całe obciążenie obliczeniowe jest po stronie dostawcy usługi.
Gemini 2.5 Flash okazał się znacznie skuteczniejszy od lokalnego Mistrala 12B. Generował teksty napisane płynniejszą polszczyzną, lepiej interpretował polecenia i bardziej rygotystycznie przestrzegał wymaganego formatu odpowiedzi.
GEMINI - UZYSKANE WYNIKI:
Gemini 2.5 Flash generowało treści ponad dwukrotnie szybciej (ok. 30 sekund na artykuł) oraz w wyższej jakości. Model również sprawniej radził sobie z bardziej złożonymi poleceniami, takimi jak wstawianie separatorów.
Korzystanie z API ma jednak swoje ograniczenia, przede wszystkim limity liczby zapytań i generowanych tokenów. Przy przetwarzaniu dużej liczby artykułów stanowiło to spore utrudnienie, którego nie było w przypadku modelu uruchamianego lokalnie.
Ostatecznie, większość tekstów wygenerowałem lokalnie przy użyciu modelu Mistral.
Przykład: Fragment zbioru uczącego. Wyczyszczone, gotowe do uczenia zestawy Pytanie-Odpowiedź (QA) oraz Instrukcja-Odpowiedź (IA).
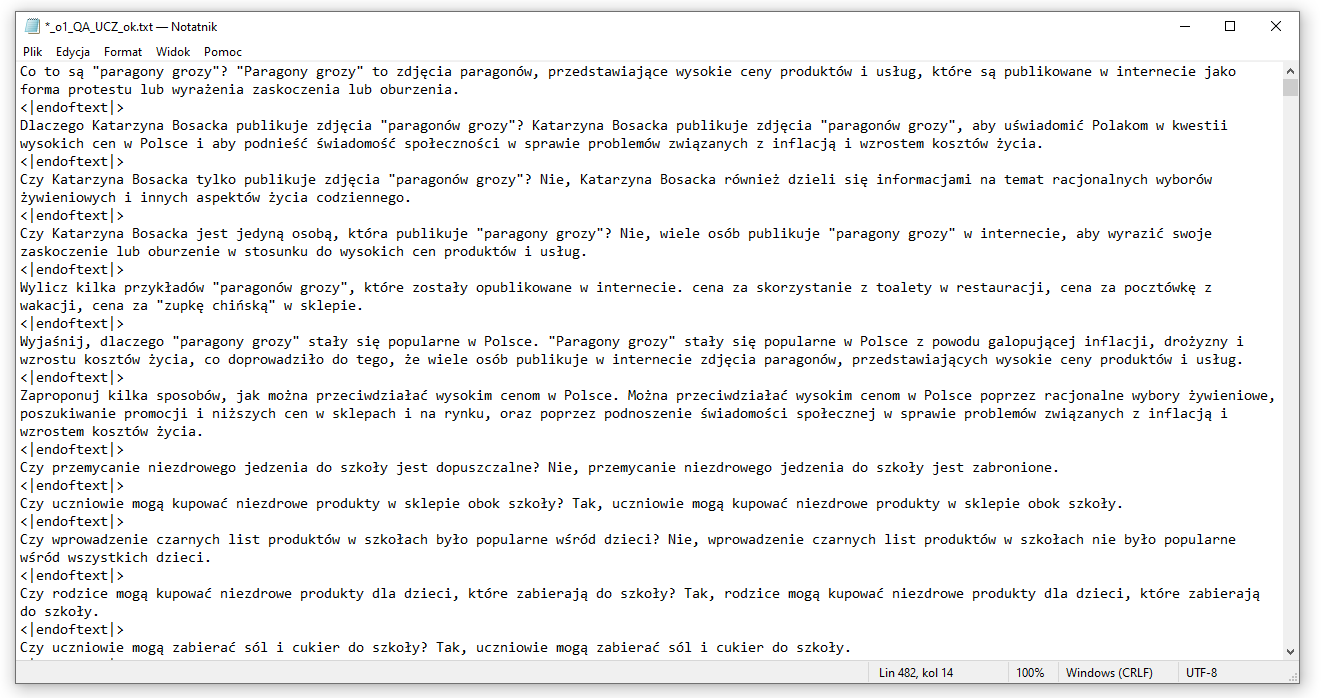
Po ponad 40 dniach generowania danych w obu środowiskach (lokalnym i chmurowym) udało mi się zebrać 616 279 par tekstów w formacie Pytanie-Odpowiedź (340 447) oraz Instrukcja-Odpowiedź (275 832).
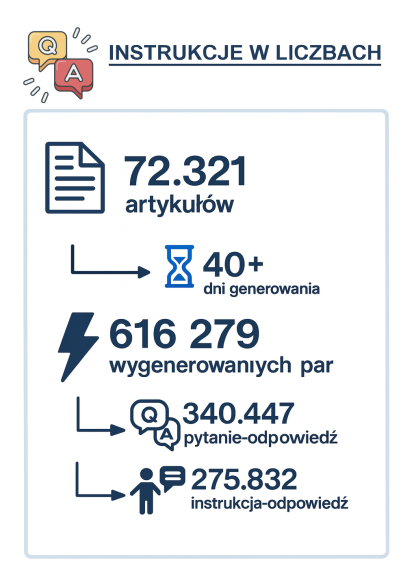
Generowanie danych syntetycznych na dużą skalę jest kosztowne i czasochłonne — wymaga dużej mocy obliczeniowej, zarówno przy korzystaniu z lokalnego GPU, jak i usług API.
Web scraping jest znacznie szybszy i tańszy, ale nie zawsze pozwala uzyskać teksty o odpowiedniej jakości i strukturze.
Alternatywą mogłoby być automatyczne tłumaczenie gotowych zestawów instrukcji z języka angielskiego. Nie zdecydowałem się jednak na to rozwiązanie, ponieważ wyniki dotychczasowych eksperymentów uznałem za wystarczające.
2b. Przygotowanie nowego zbioru treningowego
W nowym zbiorze treningowym wykorzystałem zebrane wcześniej teksty ze źródeł: Wikipedia, Pudelek, Polsat News, książki oraz Fakt. Zrezygnowałem natomiast z tekstów Wykopu i dowcipów, które — jak pokazały wcześniejsze testy — niekorzystnie wpływały na jakość odpowiedzi modelu. Model często zaczynał odpowiadać w stylu komentarzy internetowych albo udzielał odpowiedzi oderwanych od rzeczywistości.
Dodatkowo z portalu Fakt pobrałem metodami web scrapingu 67 846 nowych artykułów, opublikowanych do 12 sierpnia 2025 r. (cutoff date dla tego zbioru danych). Chodziło o aktualizację wiedzy modelu o bieżące wydarzenia, np. objęcie urzędu prezydenta USA przez Donalda Trumpa oraz prezydenta Polski przez Karola Nawrockiego. Testy pokazały, jak ważna jest aktualizacja danych treningowych. To jedno z wyzwań dla twórców modeli językowych. Wiedza tworzonego LLM musi nadążać za stale zmieniającą się rzeczywistością, inaczej udzielane odpowiedzi na tematy bieżące szybko tracą aktualność.
Najważniejszą zmianą było jednak dodanie do zbioru treningowego 616 279 syntetycznie wygenerowanych par pytań i instrukcji wraz z odpowiedziami, przygotowanych podczas wcześniejszych eksperymentów z Mistralem i Gemini.
W efekcie powstał hybrydowy zbiór treningowy, łączący oryginalne teksty źródłowe z syntetycznie wygenerowanymi parami pytań i instrukcji z odpowiedziami. Dzięki temu model uczył się zarówno na naturalnych tekstach, jak i na przykładach bezpośredniej interakcji z użytkownikiem.
Źródła i zbiory tekstów użyte do uczenia Toktumi 2.0:
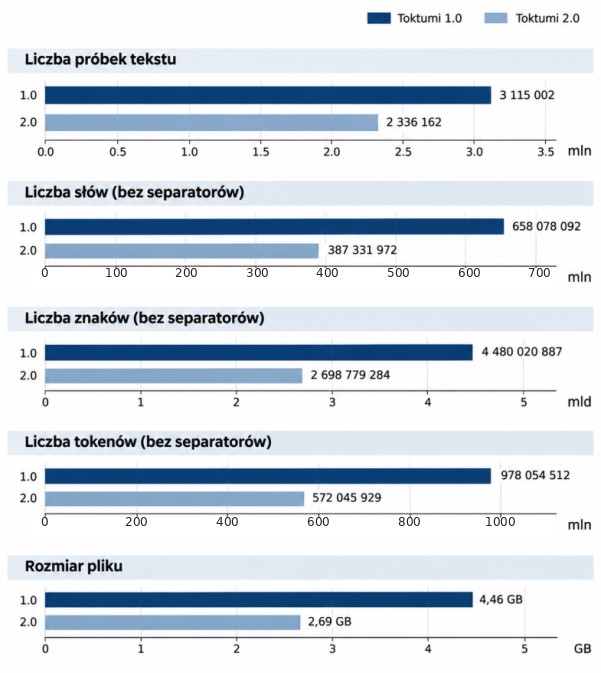
Pomimo dodania dużego zbioru instrukcji, po usunięciu danych z Wykopu (który był najliczniejszym zbiorem tekstów) plik treningowy zmniejszył się o ok. 25% (jeśli chodzi o liczbę tekstów) oraz o ok. 40% (jeśli chodzi o liczbę znaków, a także tokenów).
Ten krok, jak się później okazało, również przyczynił się do poprawy jakości modelu Toktumi 2.0.
Porównanie rozmiarów zbiorów treningowych Toktumi 1.0 | Toktumi 2.0.
2c. Trening modelu
Następnie wykonałem te same kroki, co przy uczeniu Toktumi 1.0:
- Zredukowałem korpus używanych znaków do 256 (poprzez konwersję UTF-8 → ANSI → UTF-8).
- Oddzieliłem próbki tekstu za pomocą separatora
<|endoftext|>.- Z danych treningowych wydzieliłem plik walidacyjny (plik tekstowy ok 10 MB).
- Na podstawie nowego pliku treningowego przygotowałem nowy tokenizer (vocab_size = 50 000). Należy pamiętać o konsekwencjach takiego kroku: każdy tokenizer ma własny słownik i przypisane tokenom identyfikatory, dlatego nowy tokenizer nie był kompatybilny z tokenizerem Toktumi 1.0. Była to cenna lekcja — od tego momentu zachowałem tokenizer Toktumi 2.0 we wszystkich kolejnych etapach rozwoju modelu.
- Utworzyłem pusty model GPT-2 Medium, tą samą metodą, co wcześniej.
- Rozpocząłem trening, tym razem ustawiając liczbę epok na 8 (mając na uwadze, że w trening Toktumi 1.0 zakończył się w okolicy 6,44 epoki).
Uczenie Toktumi 2.0, obliczone na mniejszą liczbę epok, oraz mniejszy plik treningowy, spowodowały, że cały proces zajął 829 048 kroków, a przejście 8 epok trwało około 11,5 doby (nie licząc technicznych przerw związanych z restartami komputera i wznawianiem treningu z checkpointów) - w porównaniu do około 15 dni (6,44 epoki) dla Toktumi 1.0.

2d. Ocena jakości. Etap 1: Perplexity.
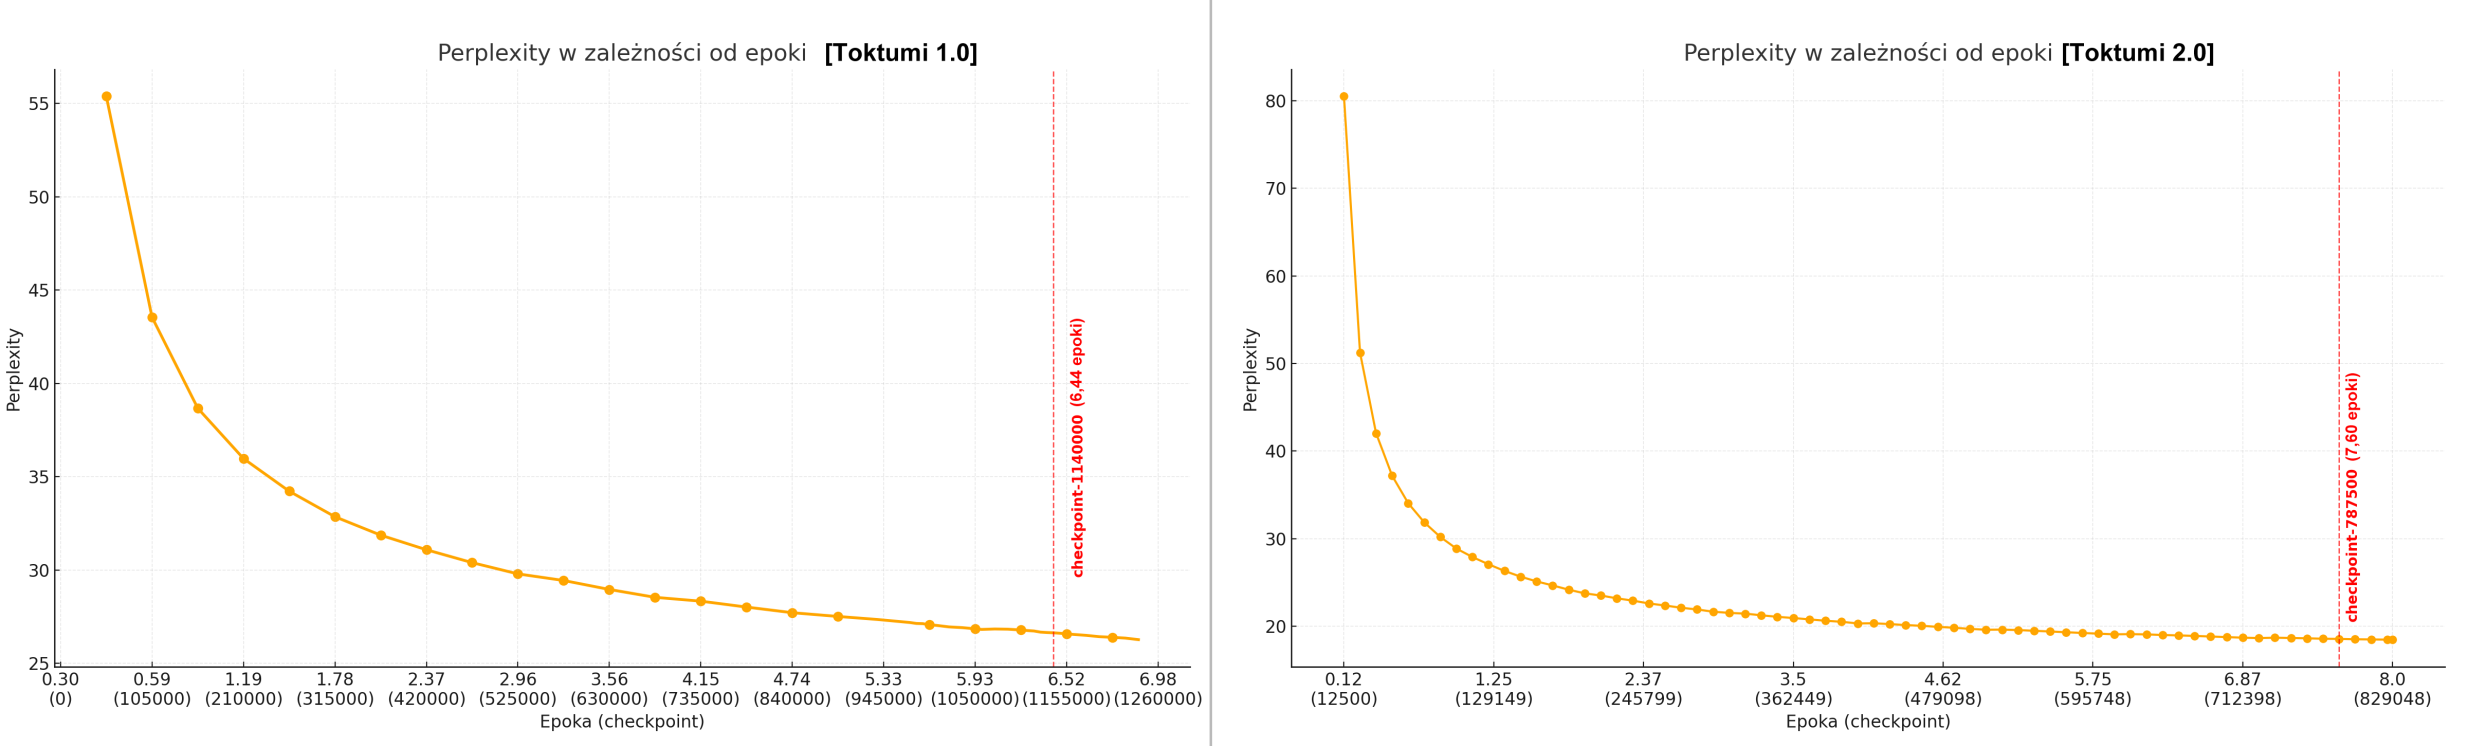
Podobnie jak w pierwszym etapie, weryfikacja modelu przebiegała dwuetapowo. Najpierw zmierzyłem wartość perpleksji (perplexity) dla kolejnych checkpointów, wykorzystując przygotowany wcześniej kod ewaluacyjny. Na poniższych wykresach przedstawiono wyniki dla obu modeli.
Krzywe uczenia obu modeli nieco się różnią. W przypadku Toktumi 1.0 perplexity obniżała się stopniowo, osiągając poziom około 26. Toktumi 2.0 charakteryzował się natomiast gwałtowniejszym spadkiem i szybkim ustabilizowaniem wartości w okolicach 19. Taki przebieg wskazuje na skuteczniejsze dopasowanie Toktumi 2.0 do danych oraz większą spójność generowanych predykcji.
Warto jednak pamiętać, że oba modele były oceniane na różnych zbiorach walidacyjnych, dlatego porównanie należy traktować orientacyjnie.
Porównanie perpleksji w modelu Toktumi 1.0 oraz Toktumi 2.0:
2e. Ocena jakości. Etap 2: Prompting.
Drugim etapem weryfikacji było przetestowanie Toktumi 2.0 na zestawie 150 promptów, tych samych, które wykorzystałem wcześniej do oceny Toktumi 1.0 (zob. Część 1).
Proces testowania zautomatyzowałem za pomocą kodu w Pythonie, który uruchamiał prompty na kolejnych checkpointach i zapisywał odpowiedzi. Następnie wyniki poddawałem własnej, ręcznej ocenie.
Ze względu na dużą liczbę odpowiedzi skorzystałem również z pomocy AI do analizy wyników. Oceny nie zawsze były jednoznaczne, ale po kilku turach porównań udało się wytypować najlepszy checkpoint.
Podobnie jak wcześniej, zastosowałem greedy decoding (top_k = 1), dzięki czemu model generował zawsze tę samą, najbardziej prawdopodobną odpowiedź. Pozwoliło to zachować jednolite warunki testowania.
Pełna lista 150 promptów i odpowiedzi modelu -> ZOBACZ.
2f. Zakończenie treningu
Ostatecznie, za najlepszy uznałem checkpoint-787500, zapisany w okolicach 7,60 epoki.
Na jego podstawie przygotowałem finalną wersję modelu Toktumi 2.0 wraz z tokenizerem.
3. Końcowa ewaluacja modelu
W ostatnim kroku przeprowadziłem końcową ewaluację i porównanie obu modeli Toktumi 1.0 i Toktumi 2.0. Żeby porównanie było spójne, opracowałem i zastosowałem jednolitą metodologię oceny. Każdą odpowiedź klasyfikowałem w dwóch krokach:
KROK 1 — Instruction Following (IF)
Czy model poprawnie rozpoznaje, strukturę wypowiedzi (Instruction Following, IF).
Na przykład: gdy otrzymuje pytanie — czy próbuje na nie odpowiedzieć tak, jak się odpowiada na pytanie; czy gdy otrzymuje instrukcję — czy próbuje odpowiedzieć tak, jak się reaguje na instrukcję; gdy otrzymuje niedokończone zdanie — czy je uzupełnia.
Przykład Toktumi 1.0:
Prompt 05: Wymień trzy warzywa.
Odpowiedź: Wymień trzy warzywa. Te z nich są najbardziej wymagające.
W powyższym przykładzie model Toktumi 1.0 nieprawidłowo odczytał strukturę polecenia. Zamiast wykonać instrukcję i wymienić trzy warzywa, kontynuował wypowiedź, jakby kontynuował prompt. Takie odpowiedzi klasyfikowałem jako NIE.
Przykład Toktumi 2.0:
Prompt 05: Wymień trzy warzywa.
Odpowiedź: - Ziemniaki, pomidory i ogórki. (np. ziemniaki, papryka, cebula).
W powyższym przykładzie model Toktumi 2.0 prawidłowo odczytał strukturę polecenia i wymienił trzy warzywa. Takie odpowiedzi oznaczałem tagiem TAK.
KROK 2 — Factuality (FCT)
W kolejnym kroku sprawdzam, czy odpowiedź jest poprawna, zgodna z faktami i ma sens (Factuality, FCT).
Odpowiedzi zawierające halucynacje, nieprawdziwe informacje lub wewnętrzne sprzeczności klasyfikowałem negatywnie, oznaczając je jako HAL.
Stosowałem przy tym liberalne kryteria oceny — odpowiedzi częściowo poprawne również mogły otrzymać ocenę TAK, jeśli kluczowa część odpowiedzi była prawidłowa.
Przykład Toktumi 1.0:
Prompt 13: Mężczyzna to osoba płci
Odpowiedź: Mężczyzna to osoba płci żeńskiej.
W powyższym przykładzie model Toktumi 1.0 rozpoznał strukturę języka i dokończył zdanie / udzielił odpowiedzi (KROK 1 → TAK). Jednak odpowiedział niezgodnie z prawdą. Takie odpowiedzi oznaczałem jako HAL. Dla uproszczenia, włączam je do tej samej grupy, co halucynacje.
Przykład Toktumi 2.0:
Prompt 13: Mężczyzna to osoba płci
Odpowiedź: Mężczyzna to osoba płci męskiej, która nie jest związana z żadną partią polityczną.
W powyższym przykładzie model Toktumi 2.0 poprawnie rozpoznał strukturę języka i dokończył zdanie / udzielił odpowiedzi (KROK 1 → TAK). Dodatkowo, odpowiedź była zgodna z wiedzą o świecie w części dotyczącej płci, natomiast dodatkowe sformułowanie o „bezpartyjności” potraktowałem jako element uboczny, który nie wpływał istotnie na ocenę poprawności. Przyjąłem podejście liberalne, skupiając się na najważniejszych elementach odpowiedzi, aby kryteria oceny nie były nadmiernie rygorystyczne. Takie częściowo poprawne odpowiedzi również klasyfikowałem jako TAK.
Przykład Toktumi 1.0:
Prompt 62: Czekolada jest
Odpowiedź: Czekolada jest zdrowa, ale niezdrowa.
W tym przypadku model Toktumi 1.0 udzielił odpowiedzi sprzecznej wewnętrznie - zawiera dwa wykluczające się stwierdzenia. Tego typu wypowiedzi traktowałem jako przykład halucynacji i również oznaczałem tagiem HAL.
Tak powstało porównanie jakości obu modeli.
Wyniki Toktumi 1.0
| Klasyfikacja [IF / FCT] | Liczba przypadków |
|---|---|
| TAK / TAK - poprawna struktura i poprawna odpowiedź | 85 |
| TAK / HAL - poprawna struktura, ale halucynacja | 33 |
| NIE - brak poprawnego rozpoznania polecenia | 32 |
| Razem | 150 |
Wyniki Toktumi 2.0
| Klasyfikacja [IF / FCT] | Liczba przypadków |
|---|---|
| TAK / TAK - poprawna struktura i poprawna odpowiedź | 102 |
| TAK / HAL - poprawna struktura, ale halucynacja | 42 |
| NIE - brak poprawnego rozpoznania polecenia | 6 |
| Razem | 150 |
WNIOSKI
- Toktumi 2.0 prezentuje wyższą jakość odpowiedzi niż wersja 1.0.
Wniosek: Ponowne uczenie modelu było słuszną decyzją, a zastosowane usprawnienia przyniosły wyraźną poprawę jakości.
- Największa poprawa dotyczy zdolności do podążania za instrukcją (Instruction Following, IF). Liczba przypadków poprawnego rozpoznania polecenia wzrosła ze 118 do 144. Jednocześnie liczba poprawnych odpowiedzi wzrosła z 85 do 102, czyli o około 20%.
Wniosek: Uczenie Toktumi 2.0 na zestawach Pytanie-Odpowiedź (QA) oraz Instrukcja-Odpowiedź (IA) było skuteczne i przełożyło się na lepsze rozpoznawanie i wykonywanie poleceń.
- W Toktumi 2.0 znacznie ograniczono problem odpowiedzi w stylu komentarzy internetowych — model rzadziej naśladuje chaotyczny, oceniający język użytkowników i znacznie częściej wchodzi w rolę przyjaznego asystenta.
Wniosek: Decyzja o usunięciu komentarzy z Wykopu ze zbioru treningowego była słuszna i poprawiła jakość generowanych odpowiedzi. Pokazuje to, że jakość danych treningowych bywa ważniejsza niż ich ilość.
DODATKOWE SPOSTRZEŻENIA
Toktumi 2.0 znacząco lepiej radzi sobie z poleceniami w formie instrukcji niż wersja 1.0.
[Toktumi 1.0]
Prompt 08: Podaj przykład emocji.
Odpowiedź: Komentarz: Nie ma to jak wmawiać ludziom, że są lepsi od innych.
[Toktumi 2.0]
Prompt 08: Podaj przykład emocji.
Odpowiedź: Przykładem emocji może być radość, radość lub smutek, gdy ktoś jest szczęśliwy i cieszy się z tego, co ma.
Na 14 instrukcji w zbiorze (typu podaj..., wymień...) Toktumi 1.0 poprawnie (IF=TAK) odpowiedział tylko w 1 z 14 przypadków, podczas gdy Toktumi 2.0 zrobił to aż w 13 z 14 przypadków.
Czyli: w zakresie instrukcji Toktumi 2.0 wykazuje ogromny postęp w rozpoznawaniu i wykonywaniu poleceń, w porównaniu z niemal całkowitą nieskutecznością w tym zakresie Toktumi 1.0.
Oba modele nadal wykazywały problemy z wiedzą faktograficzną, nawet w przypadku bardzo prostych pytań.
Dobrą ilustracją jest poniższy przykład z ołówkiem.
[Toktumi 2.0]
Prompt 91: Do czego służy ołówek?
Odpowiedź: Ołówek to jeden z najpopularniejszych przedmiotów codziennego użytku. Jest niezbędny do prawidłowego funkcjonowania organizmu, a także do pracy fizycznej i psychicznej. Jego używanie jest bardzo proste, jednak nie każdy wie, jak się do tego zabrać. Jak się go pozbyć?
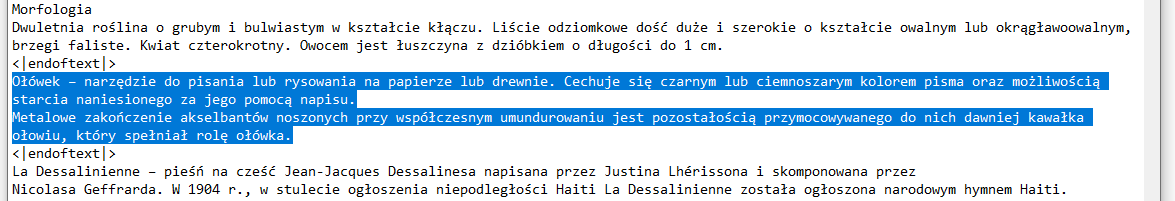
Co ciekawe, definicja słowa „ołówek” z Wikipedii znajdowała się w zbiorze treningowym obu modeli. Mimo to model nie potrafił poprawnie odpowiedzieć na tak proste pytanie.
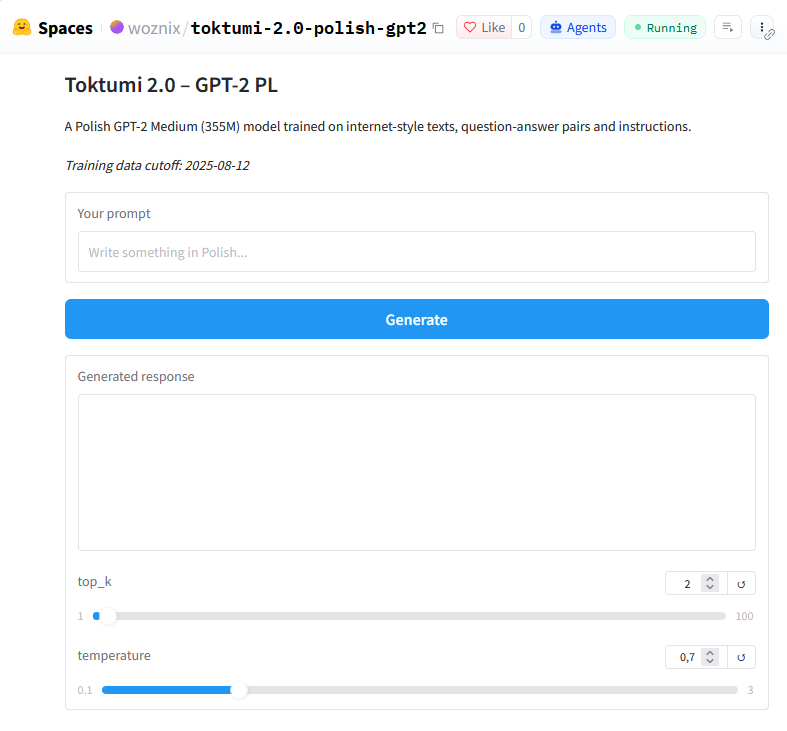
Eksperyment: Po zwiększeniu parametru top_k z 1 do 2 i wprowadzeniu elementu losowości model wygenerował odpowiedź znacznie bliższą oczekiwanej definicji.
Prompt: Do czego służy ołówek?
Odpowiedź: Ołówki to bardzo praktyczne i uniwersalne narzędzia do pisania. Są one nie tylko ozdobą, ale także ułatwiają pisanie tekstów oraz ich czytanie w różnych miejscach na świecie - od Londynu po Los Angeles czy Chicago.
Wniosek: Sama obecność informacji w zbiorze treningowym nie gwarantuje, że model po otrzymaniu zapytania uzna ją za najbardziej oczywistą odpowiedź (w trybie greedy decoding). Eksperyment pokazał również, jak duży wpływ na generowane odpowiedzi mogą mieć ustawienia hiperparametrów i techniki promptowania.
PODSUMOWANIE
W tej części opisałem drugi etap rozwoju modelu Toktumi (Toktumi 2.0), w którym wykorzystałem doświadczenia i wnioski z pierwszego treningu (Toktumi 1.0). Najważniejszą zmianą było przebudowanie zbioru treningowego — usunięcie problematycznych komentarzy internetowych oraz wprowadzenie 616 279 syntetycznie wygenerowanych par pytań i instrukcji wraz z odpowiedziami, przygotowanych z wykorzystaniem modeli Mistral i Gemini.
W efekcie powstał hybrydowy zbiór treningowy, liczący 2 336 162 próbki tekstów, łączący naturalne teksty źródłowe z przykładami interakcji z użytkownikiem. Na jego podstawie przygotowałem nowy tokenizer i ponownie wytrenowałem model GPT-2 Medium od podstaw, na domowej karcie graficznej.
Wyniki potwierdziły, że obrany kierunek zmian był właściwy — w teście 150 promptów liczba poprawnych odpowiedzi wzrosła z 85 do 102, a przypadków prawidłowego rozpoznania polecenia ze 118 do 144.
Eksperyment pokazał, jak duże znaczenie ma jakość i struktura danych treningowych, a nie tylko ich liczba. Mimo mniejszego zbioru tekstów Toktumi 2.0 znacznie lepiej radził sobie z poleceniami i rzadziej naśladował chaotyczny styl komentarzy internetowych.
Największym nierozwiązanym problemem pozostała wiedza faktograficzna. Model nadal często halucynuje i ma trudności z udzielaniem poprawnych odpowiedzi nawet na proste pytania. Uznałem więc, że warto pójść o krok dalej — zamiast ponownie trenować model od zera, kontynuować uczenie Toktumi 2.0 na nowym, przygotowanym syntetycznie zbiorze krótkich pytań, instrukcji i dialogów.
Dalszy rozwój modelu opisuję w Części 3.
Model Toktumi 2.0 w Hugging Face Spaces
Model Toktumi 2.0 można przetestować na platformie Hugging Face Spaces:
https://huggingface.co/spaces/miczac/toktumi-2.0-polish-gpt2
About the author
- My background combines linguistics and copywriting with Python, Big Data, machine learning, and AI. I'm also interested in data analysis, automation, and natural language processing.
Comments
Join the discussionNo comments yet. Be the first to comment.
Jak zbudować duży model językowy od zera? Toktumi (GPT-2)
Trzyczęściowy projekt budowy i rozwoju polskiego modelu językowego Toktumi, opartego na architekturze GPT-2. Od zebrania danych i treningu od zera, przez udoskonalenie zbioru treningowego, aż po fine-tuning i ocenę jakości modelu.